Как проверить формулы и структуру XLSX после правки ИИ в Windows
Read-only скрипт на Python показывает листы и координаты формул в двух XLSX, находит изменения и отклоняет опасные архивы до разбора XML.
- Программы
- Python 3.12.14
Подробности проверки
- Авторская самопроверка: Windows, PowerShell 7.6.5, Python 3.12.14 из bundled runtime, стандартная библиотека.
- На синтетических XLSX проверены коды 0/1/2, изменение формулы при неизменном кэше, добавление/удаление/переименование листов, явный отказ для shared/array, traversal, высокой степени сжатия, избытка ZIP-записей, UTF-8/DTD/ENTITY, стандартных externalLinks и повреждённого ZIP
- SHA-256 входных XLSX не изменился.

Правка таблицы с помощью ИИ может оставить книгу внешне аккуратной, но изменить формулу, удалить её или переименовать лист. Обычное сравнение размеров файлов здесь мало помогает: XLSX — это ZIP-контейнер из XML-частей, а служебные метки времени и порядок сжатия могут различаться даже при одинаковом содержимом.
Ниже мы сравним две небольшие локальные копии XLSX: версию до правки и версию после неё. Скрипт только читает архив, показывает список листов и координаты формул, а затем сообщает об изменениях. Он не открывает Excel, не извлекает файлы на диск, не записывает в книгу и не вычисляет формулы.
Что потребуется
- Windows и PowerShell.
- Уже установленный Python 3.12 с доступной командой python. Инструкция не скачивает и не устанавливает Python.
- Две отдельные копии одного небольшого XLSX: до правки и после правки ИИ.
- Файлы без пароля, макросов, внешних связей, секретов и персональных данных.
Не запускайте проверку на единственном экземпляре рабочей книги. Создайте две копии с понятными именами, например before.xlsx и after.xlsx, и поместите их в отдельную учебную папку.
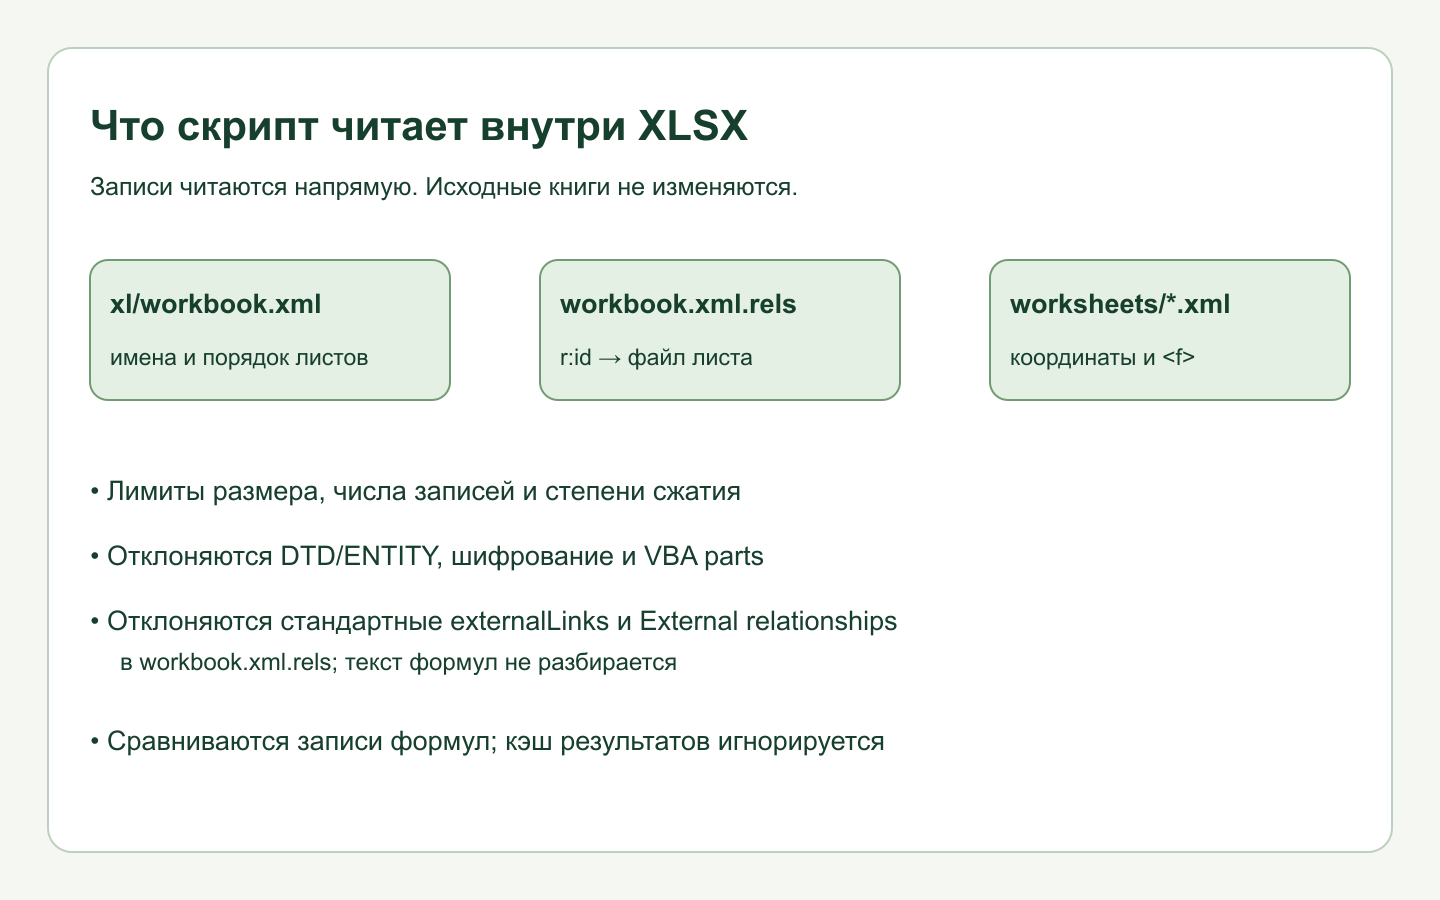
Что именно проверяет скрипт
| Проверка | Что попадёт в отчёт |
|---|---|
| Список листов | добавление, удаление, безопасно распознанное переименование и изменение порядка |
| Формула в ячейке | добавление, удаление или изменение текста и атрибутов формулы |
| Кэш результата | игнорируется: значение из XML-элемента v не доказывает, что формула пересчитана |
| Форматирование и обычные значения | не сравниваются |
Имя листа находится в xl/workbook.xml, а путь к его XML-файлу определяется через relationship r:id. Скрипт использует эту связь, а не предполагает, что первый лист всегда хранится в sheet1.xml. Переименование считается надёжно распознанным только когда у листа совпадают и sheetId, и relationship target.
Шаг 1. Проверьте Python и создайте папку
python --version
New-Item -ItemType Directory -Path .\xlsx-formula-check
Set-Location .\xlsx-formula-check
Get-Location
Если python не найден, открывает Microsoft Store или показывает не 3.12, остановитесь. Используйте проверенную установку Python 3.12 или другой согласованный процесс. После создания папки скопируйте в неё before.xlsx и after.xlsx.
Шаг 2. Сохраните скрипт
Выполните notepad .\compare_xlsx.py, вставьте весь код ниже и сохраните файл в UTF-8. Скрипт использует только стандартную библиотеку Python.
notepad .\compare_xlsx.py#!/usr/bin/env python3
"""Read-only comparison of worksheet names and formula records in two XLSX files."""
from __future__ import annotations
import argparse
import posixpath
import re
import sys
import zipfile
from dataclasses import dataclass
from pathlib import Path, PurePosixPath
from xml.etree import ElementTree as ET
MAX_ARCHIVE_BYTES = 25 * 1024 * 1024
MAX_ENTRIES = 2_000
MAX_ENTRY_BYTES = 16 * 1024 * 1024
MAX_UNCOMPRESSED_BYTES = 80 * 1024 * 1024
MAX_COMPRESSION_RATIO = 100
MAX_XML_BYTES = 16 * 1024 * 1024
NS_MAIN = "http://schemas.openxmlformats.org/spreadsheetml/2006/main"
NS_REL_DOC = "http://schemas.openxmlformats.org/officeDocument/2006/relationships"
NS_REL_PKG = "http://schemas.openxmlformats.org/package/2006/relationships"
WORKSHEET_REL_SUFFIX = "/worksheet"
FORBIDDEN_XML = re.compile(r"<!\s*(?:DOCTYPE|ENTITY)\b", re.IGNORECASE)
XML_DECLARATION_ENCODING = re.compile(
r"^\s*<\?xml\b[^>]*\bencoding\s*=\s*['\"]([^'\"]+)['\"]",
re.IGNORECASE,
)
class UnsafeWorkbook(Exception):
"""The workbook cannot be inspected within this script's safety contract."""
@dataclass(frozen=True)
class Formula:
coordinate: str
text: str
formula_type: str
shared_index: str
reference: str
@dataclass(frozen=True)
class Sheet:
name: str
sheet_id: str
target: str
order: int
formulas: tuple[Formula, ...]
@property
def identity(self) -> tuple[str, str]:
return self.sheet_id, self.target
def safe_member_name(name: str) -> None:
if not name or "\\" in name or "\x00" in name:
raise UnsafeWorkbook(f"опасное имя ZIP-записи: {name!r}")
path = PurePosixPath(name)
if path.is_absolute() or any(part in {"", ".", ".."} for part in path.parts):
raise UnsafeWorkbook(f"опасное имя ZIP-записи: {name!r}")
if not path.parts:
raise UnsafeWorkbook(f"опасное имя ZIP-записи: {name!r}")
if ":" in path.parts[0]:
raise UnsafeWorkbook(f"опасное имя ZIP-записи: {name!r}")
def validate_archive(path: Path) -> zipfile.ZipFile:
try:
size = path.stat().st_size
except OSError as error:
raise UnsafeWorkbook(f"не удалось прочитать файл {path}: {error}") from error
if size > MAX_ARCHIVE_BYTES:
raise UnsafeWorkbook(f"архив больше лимита {MAX_ARCHIVE_BYTES} байт")
try:
archive = zipfile.ZipFile(path, "r")
except (OSError, zipfile.BadZipFile) as error:
raise UnsafeWorkbook(f"неверный ZIP/XLSX: {error}") from error
try:
infos = archive.infolist()
if len(infos) > MAX_ENTRIES:
raise UnsafeWorkbook(f"слишком много ZIP-записей: {len(infos)} > {MAX_ENTRIES}")
seen: set[str] = set()
total_size = 0
total_compressed = 0
for info in infos:
safe_member_name(info.filename)
if info.filename in seen:
raise UnsafeWorkbook(f"повторяющаяся ZIP-запись: {info.filename}")
seen.add(info.filename)
if info.flag_bits & 0x1:
raise UnsafeWorkbook(f"зашифрованная ZIP-запись не поддерживается: {info.filename}")
if info.file_size > MAX_ENTRY_BYTES:
raise UnsafeWorkbook(
f"распакованный размер {info.filename} больше {MAX_ENTRY_BYTES} байт"
)
total_size += info.file_size
total_compressed += info.compress_size
if total_size > MAX_UNCOMPRESSED_BYTES:
raise UnsafeWorkbook(
f"суммарный распакованный размер больше {MAX_UNCOMPRESSED_BYTES} байт"
)
if info.file_size and info.compress_size == 0:
raise UnsafeWorkbook(f"нулевой сжатый размер у непустой записи: {info.filename}")
if info.compress_size and info.file_size / info.compress_size > MAX_COMPRESSION_RATIO:
raise UnsafeWorkbook(
f"степень сжатия {info.filename} выше {MAX_COMPRESSION_RATIO}:1"
)
if total_size and total_compressed and total_size / total_compressed > MAX_COMPRESSION_RATIO:
raise UnsafeWorkbook(f"общая степень сжатия выше {MAX_COMPRESSION_RATIO}:1")
return archive
except Exception:
archive.close()
raise
def read_xml(archive: zipfile.ZipFile, name: str) -> ET.Element:
try:
info = archive.getinfo(name)
except KeyError as error:
raise UnsafeWorkbook(f"нет обязательной части {name}") from error
if info.file_size > MAX_XML_BYTES:
raise UnsafeWorkbook(f"XML {name} больше {MAX_XML_BYTES} байт")
try:
data = archive.read(info)
except (OSError, RuntimeError, zipfile.BadZipFile) as error:
raise UnsafeWorkbook(f"не удалось прочитать {name}: {error}") from error
if b"\x00" in data:
raise UnsafeWorkbook(f"XML {name} должен быть в UTF-8, UTF-16/32 не поддерживаются")
try:
xml_text = data.decode("utf-8-sig")
except UnicodeDecodeError as error:
raise UnsafeWorkbook(f"XML {name} должен быть в UTF-8: {error}") from error
encoding_match = XML_DECLARATION_ENCODING.match(xml_text)
if encoding_match and encoding_match.group(1).lower().replace("_", "-") not in {"utf-8", "utf8"}:
raise UnsafeWorkbook(f"XML {name} объявляет неподдерживаемую кодировку")
if FORBIDDEN_XML.search(xml_text):
raise UnsafeWorkbook(f"DOCTYPE/ENTITY запрещены в {name}")
try:
return ET.fromstring(xml_text)
except ET.ParseError as error:
raise UnsafeWorkbook(f"ошибка XML в {name}: {error}") from error
def normalize_target(base: str, target: str) -> str:
if not target or "\\" in target or target.startswith("/"):
raise UnsafeWorkbook(f"опасная цель relationship: {target!r}")
joined = posixpath.normpath(posixpath.join(posixpath.dirname(base), target))
safe_member_name(joined)
if not joined.startswith("xl/"):
raise UnsafeWorkbook(f"worksheet relationship выходит за xl/: {target!r}")
return joined
def detect_unsupported_parts(archive: zipfile.ZipFile) -> None:
names = {item.filename.lower() for item in archive.infolist()}
if any(name.endswith("vbaproject.bin") for name in names):
raise UnsafeWorkbook("книги с макросами VBA не поддерживаются")
if any(name.startswith("xl/externallinks/") for name in names):
raise UnsafeWorkbook("книги с внешними связями не поддерживаются")
def load_workbook(path: Path) -> tuple[Sheet, ...]:
with validate_archive(path) as archive:
detect_unsupported_parts(archive)
workbook = read_xml(archive, "xl/workbook.xml")
rels_root = read_xml(archive, "xl/_rels/workbook.xml.rels")
relationships: dict[str, str] = {}
seen_relationship_ids: set[str] = set()
seen_worksheet_targets: set[str] = set()
for rel in rels_root.findall(f"{{{NS_REL_PKG}}}Relationship"):
rel_id = rel.get("Id", "")
rel_type = rel.get("Type", "")
if not rel_id or rel_id in seen_relationship_ids:
raise UnsafeWorkbook(f"пустой или повторный relationship Id: {rel_id!r}")
seen_relationship_ids.add(rel_id)
if rel.get("TargetMode", "Internal") == "External":
raise UnsafeWorkbook(f"внешняя relationship {rel_id} не поддерживается")
if rel_type.endswith(WORKSHEET_REL_SUFFIX):
target = normalize_target("xl/workbook.xml", rel.get("Target", ""))
if target in seen_worksheet_targets:
raise UnsafeWorkbook(f"повторная цель worksheet relationship: {target}")
seen_worksheet_targets.add(target)
relationships[rel_id] = target
sheets_node = workbook.find(f"{{{NS_MAIN}}}sheets")
if sheets_node is None:
raise UnsafeWorkbook("в workbook.xml нет списка sheets")
result: list[Sheet] = []
seen_sheet_names: set[str] = set()
seen_sheet_ids: set[str] = set()
seen_sheet_targets: set[str] = set()
for order, node in enumerate(sheets_node.findall(f"{{{NS_MAIN}}}sheet"), start=1):
name = node.get("name", "")
sheet_id = node.get("sheetId", "")
rel_id = node.get(f"{{{NS_REL_DOC}}}id", "")
if not name or not sheet_id or rel_id not in relationships:
raise UnsafeWorkbook(f"неполная или неверная запись sheet: {name!r}")
target = relationships[rel_id]
if name in seen_sheet_names or sheet_id in seen_sheet_ids or target in seen_sheet_targets:
raise UnsafeWorkbook(
f"повторные name, sheetId или worksheet target в списке sheets: {name!r}"
)
seen_sheet_names.add(name)
seen_sheet_ids.add(sheet_id)
seen_sheet_targets.add(target)
root = read_xml(archive, target)
formulas: list[Formula] = []
seen_coordinates: set[str] = set()
for cell in root.findall(f".//{{{NS_MAIN}}}c"):
formula = cell.find(f"{{{NS_MAIN}}}f")
if formula is None:
continue
coordinate = cell.get("r", "")
if not coordinate or coordinate in seen_coordinates:
raise UnsafeWorkbook(f"неверная или повторная координата формулы в {target}")
seen_coordinates.add(coordinate)
formula_type = formula.get("t", "normal")
if formula_type != "normal":
raise UnsafeWorkbook(
f"неподдерживаемый тип формулы {formula_type!r} в {name}!{coordinate}; "
"shared/array/dataTable требуют отдельной проверки"
)
formulas.append(
Formula(
coordinate=coordinate,
text=formula.text or "",
formula_type=formula_type,
shared_index=formula.get("si", ""),
reference=formula.get("ref", ""),
)
)
formulas.sort(key=lambda item: item.coordinate)
result.append(Sheet(name, sheet_id, target, order, tuple(formulas)))
return tuple(result)
def describe_formula(item: Formula) -> str:
attrs = []
if item.formula_type != "normal":
attrs.append(f"type={item.formula_type}")
if item.shared_index:
attrs.append(f"si={item.shared_index}")
if item.reference:
attrs.append(f"ref={item.reference}")
suffix = f" [{', '.join(attrs)}]" if attrs else ""
shown = item.text if item.text else "<пустой текст формулы>"
return f"{item.coordinate}: ={shown}{suffix}"
def compare(before: tuple[Sheet, ...], after: tuple[Sheet, ...]) -> list[str]:
changes: list[str] = []
before_map = {sheet.identity: sheet for sheet in before}
after_map = {sheet.identity: sheet for sheet in after}
for identity in sorted(before_map.keys() - after_map.keys()):
changes.append(f"SHEET REMOVED: {before_map[identity].name}")
for identity in sorted(after_map.keys() - before_map.keys()):
changes.append(f"SHEET ADDED: {after_map[identity].name}")
for identity in sorted(before_map.keys() & after_map.keys()):
old = before_map[identity]
new = after_map[identity]
label = new.name
if old.name != new.name:
changes.append(f"SHEET RENAMED: {old.name} -> {new.name}")
label = f"{old.name} -> {new.name}"
if old.order != new.order:
changes.append(f"SHEET MOVED: {label}: {old.order} -> {new.order}")
old_formulas = {item.coordinate: item for item in old.formulas}
new_formulas = {item.coordinate: item for item in new.formulas}
for coordinate in sorted(old_formulas.keys() - new_formulas.keys()):
changes.append(f"FORMULA REMOVED [{label}] {describe_formula(old_formulas[coordinate])}")
for coordinate in sorted(new_formulas.keys() - old_formulas.keys()):
changes.append(f"FORMULA ADDED [{label}] {describe_formula(new_formulas[coordinate])}")
for coordinate in sorted(old_formulas.keys() & new_formulas.keys()):
if old_formulas[coordinate] != new_formulas[coordinate]:
changes.append(
f"FORMULA CHANGED [{label}] {coordinate}: "
f"{describe_formula(old_formulas[coordinate]).split(': ', 1)[1]} -> "
f"{describe_formula(new_formulas[coordinate]).split(': ', 1)[1]}"
)
return changes
def print_inventory(title: str, sheets: tuple[Sheet, ...]) -> None:
print(title)
for sheet in sheets:
print(f" {sheet.order}. {sheet.name} — формул: {len(sheet.formulas)}")
for formula in sheet.formulas:
print(f" {describe_formula(formula)}")
def main() -> int:
parser = argparse.ArgumentParser(
description="Сравнить список листов и формулы в двух XLSX, не изменяя и не распаковывая их."
)
parser.add_argument("before", type=Path, help="копия XLSX до правки")
parser.add_argument("after", type=Path, help="копия XLSX после правки")
args = parser.parse_args()
try:
before = load_workbook(args.before)
after = load_workbook(args.after)
except UnsafeWorkbook as error:
print(f"ОШИБКА: {error}", file=sys.stderr)
return 2
print_inventory("ДО:", before)
print_inventory("ПОСЛЕ:", after)
changes = compare(before, after)
if not changes:
print("Изменений в списке листов и записях формул не найдено.")
return 0
print(f"Найдено изменений: {len(changes)}")
for change in changes:
print(change)
return 1
if __name__ == "__main__":
raise SystemExit(main())
Какие ограничения срабатывают до чтения XML
Сначала проверяется весь ZIP-каталог. Архив отклоняется, если сам XLSX больше 25 МиБ, содержит более 2000 записей, одна распакованная запись больше 16 МиБ, суммарный распакованный объём больше 80 МиБ или степень сжатия отдельной записи либо архива выше 100:1. Эти пределы нужны против архивов, которые выглядят маленькими, но резко разрастаются при чтении.
Каждое имя ZIP-записи проверяется на абсолютный путь, .., обратную косую черту, нулевой байт и дисковый префикс. Скрипт всё равно ничего не извлекает: он читает только нужные записи через zipfile. Перед XML-разбором он принимает только UTF-8, отклоняет DTD и ENTITY уже в декодированном тексте и ограничивает одну XML-часть 16 МиБ. UTF-16 и UTF-32 сознательно не поддерживаются, чтобы запрет нельзя было обойти другой байтовой кодировкой.
Шаг 3. Запустите сравнение
python .\compare_xlsx.py .\before.xlsx .\after.xlsx
$code = $LASTEXITCODE
"Код завершения: $code"
Сохраните $LASTEXITCODE сразу после Python: любая следующая команда может его заменить. Код 0 означает, что список листов и записи формул совпали. Код 1 означает найденные изменения. Код 2 означает, что хотя бы один файл не прошёл безопасный разбор, поэтому сравнение нельзя считать выполненным.
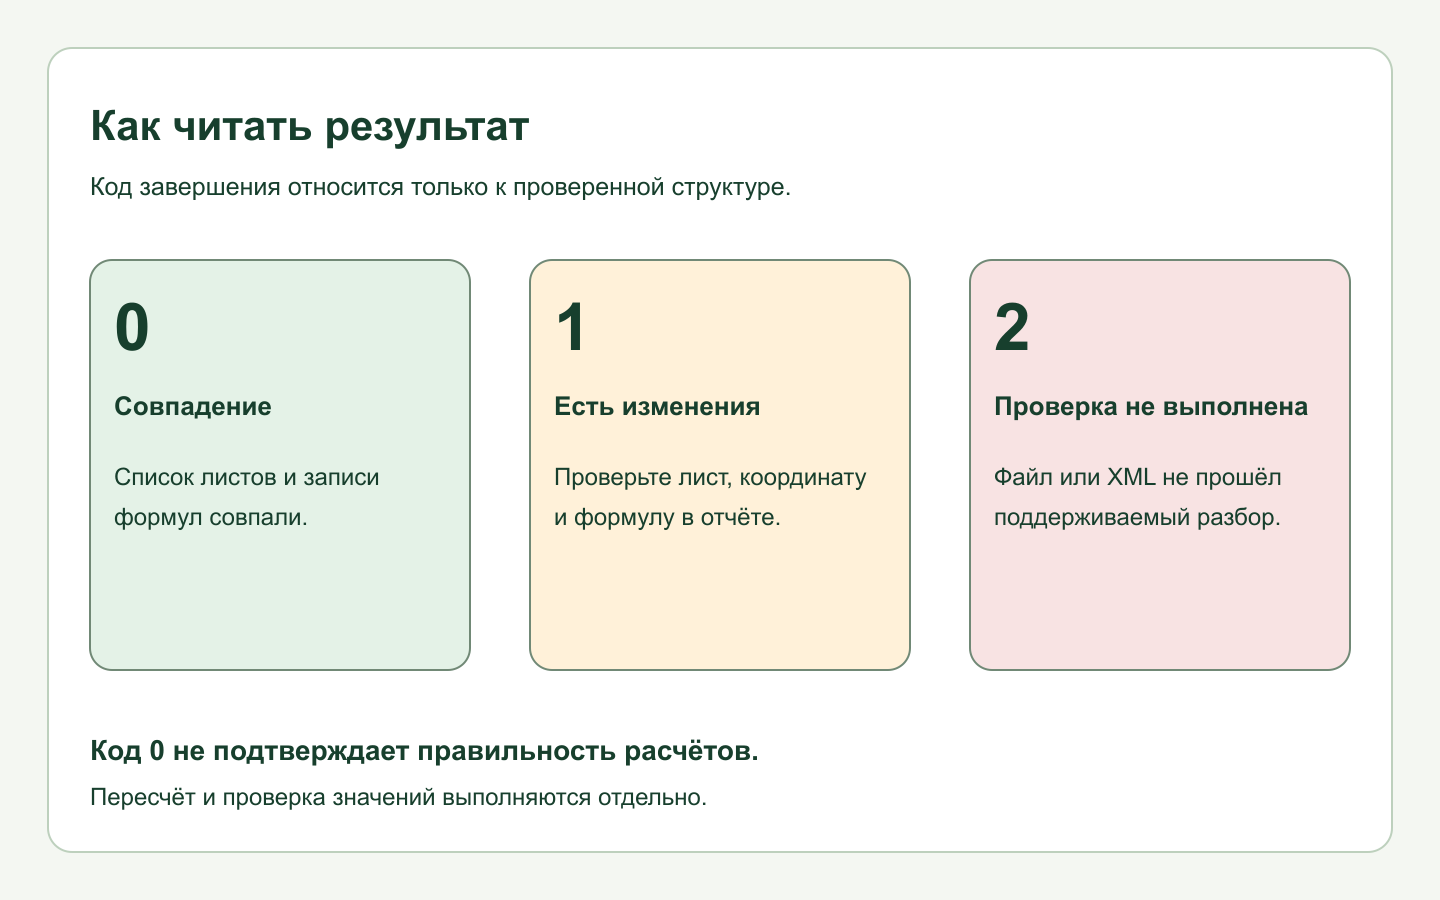
Как читать отчёт
Сначала скрипт печатает инвентаризацию ДО и ПОСЛЕ: имя каждого листа, число формул и строки вида B2: =SUM(A1:A2). Затем идёт список структурных изменений. На учебной паре он может выглядеть так:
Найдено изменений: 5
SHEET REMOVED: Notes
SHEET ADDED: Added
SHEET RENAMED: Budget -> Plan
FORMULA REMOVED [Budget -> Plan] C2: =A1*2
FORMULA CHANGED [Budget -> Plan] B2: =SUM(A1:A2) -> =SUM(A1:A3)
Код завершения: 1
В этом примере формула B2 изменилась, хотя сохранённый в XML кэш результата остался прежним. Это полезная ловушка: одинаковое число в Excel может скрывать изменённую формулу или отсутствие пересчёта. Скрипт намеренно не сравнивает кэш как доказательство правильности.
Шаг 4. Разберите каждое изменение
- Для SHEET ADDED и SHEET REMOVED убедитесь, что изменение состава книги было ожидаемым.
- Для SHEET RENAMED проверьте новое имя и ссылки на этот лист в других формулах.
- Для FORMULA ADDED, REMOVED и CHANGED откройте обе копии в привычном табличном редакторе и сопоставьте формулу с задачей.
- После ручного просмотра пересчитайте изменённую копию в доверенном приложении и проверьте итоговые значения отдельно. Этот скрипт пересчёт не выполняет.
Общие и массивные формулы
В OOXML общая формула может хранить полный текст только в ведущей ячейке, а зависимые ячейки — пустой XML-элемент f с одинаковым shared index. Массивная формула также описывает диапазон, а не одну независимую ячейку. Скрипт не пытается разворачивать такие конструкции и явно завершает работу с кодом 2 при типах shared, array или dataTable. Для них нужен отдельный инструмент, который понимает диапазон и правила конкретного табличного редактора.
Когда скрипт остановится
- XLSX защищён паролем или содержит зашифрованную ZIP-запись.
- В книге есть VBA-макросы либо стандартные части externalLinks. Они требуют отдельной проверки и здесь сознательно отклоняются.
- Архив повреждён, содержит опасное имя, подозрительно высокое сжатие или превышает лимиты.
- XML не является UTF-8, повреждён, содержит DTD/ENTITY или использует неподдерживаемую структуру.
При коде 2 не используйте частичный вывод. Не повышайте лимиты только ради прохождения неизвестного файла: сначала выясните происхождение книги и выберите изолированный, проверенный процесс для больших или сложных документов.
Ограничения метода
- Скрипт не сравнивает значения без формул, стили, диаграммы, таблицы, проверки данных, комментарии, изображения, скрытые объекты и именованные диапазоны.
- Он не оценивает смысл и корректность формулы и не запускает Excel. Код 0 говорит только о совпадении проверяемой структуры.
- Кэшированные результаты из XML-элемента v не используются; книга может требовать пересчёта в табличном редакторе.
- Shared-, array-, dataTable- и динамические формулы не сравниваются: при явном нестандартном типе скрипт возвращает код 2. Он не распространяет формулы по диапазону и не моделирует поведение Excel.
- Книги с макросами, шифрованием и стандартными частями externalLinks не поддерживаются. Синтаксис самой формулы не разбирается, поэтому ссылка на внешнюю книгу, записанная только внутри текста формулы, может попасть в отчёт как обычный текст. Файлы Strict Open XML и необычные расширения OOXML также могут потребовать другой инструмент.
- Разные программы могут переписать эквивалентную формулу или перенумеровать worksheet parts. В таком случае лист может выглядеть удалённым и добавленным; переименование распознаётся только при совпадении sheetId и relationship target. Отчёт показывает структурную разницу, но не доказывает изменение намерения автора.
Как убрать учебные файлы
Скрипт не меняет before.xlsx и after.xlsx, поэтому откатывать книгу не нужно. Если вы работали только с копиями, сначала убедитесь, что PowerShell открыт именно в созданной папке, и просмотрите точные имена.
Get-Location
Get-ChildItem -LiteralPath .
Remove-Item -LiteralPath .\compare_xlsx.py, .\before.xlsx, .\after.xlsx
Не используйте рекурсивное удаление, маски и путь к домашней папке. Если копии нужны для аудита, сохраните их вместе с выводом команды в защищённом месте вместо удаления.
Когда проверка завершена
Проверка завершена, когда оба файла прошли безопасный разбор, вы сохранили код завершения, просмотрели состав листов и каждую формулу из отчёта, а найденные изменения подтвердили по задаче. Для изменённой книги отдельно нужен пересчёт и проверка результатов в доверенном табличном редакторе.

