Почему реалистичные синтетические данные ещё не доказывают качество корпоративного ИИ
Microsoft строит вымышленные компании для проверки Copilot. Разбираем, что измеряют качество данных, поиск, обоснованность и полнота ответа — и почему эти показатели нельзя смешивать.

Microsoft 30 октября описала систему, которая строит вымышленные компании для проверки Copilot: сотрудников, документы, письма, встречи и историю проектов. Это полезный ответ на практическую проблему корпоративного ИИ: как сравнивать версии помощника на сложных рабочих задачах, не передавая в тестовый набор переписку клиентов. Но реалистичность такого мира и качество ответов внутри него — разные предметы измерения. Из опубликованных результатов пока нельзя вывести точность Copilot на рабочих данных конкретной организации.
Разобраться помогает цепочка из пяти звеньев: синтетическая организация, её история, запрос пользователя, ожидаемый ответ и отдельные оценки поиска и генерации. Слабость любого звена меняет смысл итогового результата. Важен не только ответ на вопрос «похожи ли письма на настоящие», но и то, какие ошибки помощника этот набор вообще способен обнаружить.
Сначала компания, затем её память
В терминологии Microsoft tenant — изолированная организационная среда со своими пользователями, данными и настройками. В проекте созданы три такие среды: фармацевтическая, для рынков капитала и для IT-компании. По сообщению авторов, в каждой теперь сотни пользователей с историями коммуникаций. Вместо набора случайных документов получается связанный рабочий контекст: кто кому подчиняется, над чем работают команды и как обсуждения превращаются в решения.
Для правдоподобия Microsoft использует открытые сигналы: базу профессий O*NET, вакансии и отчётность SEC. Они помогают задавать роли, обязанности, структуру подразделений и масштаб бизнеса. Компания сообщает, что источники прошли её юридическую и политическую проверку. Это основание для построения симуляции, но не подтверждение того, что распределение её задач совпадает с запросами всех реальных клиентов Copilot.
Особенно важна временная структура. Встреча должна предшествовать письму с её итогами, новое решение — менять старое, а сотрудник — получать роль в определённый момент. Microsoft описывает истории встреч, цепочки писем, проектные сроки и организационные изменения. Без таких связей вопрос «что изменилось после последнего обзора?» превращается в поиск похожих слов: проверить понимание изменения невозможно, если изменения в данных не произошло.
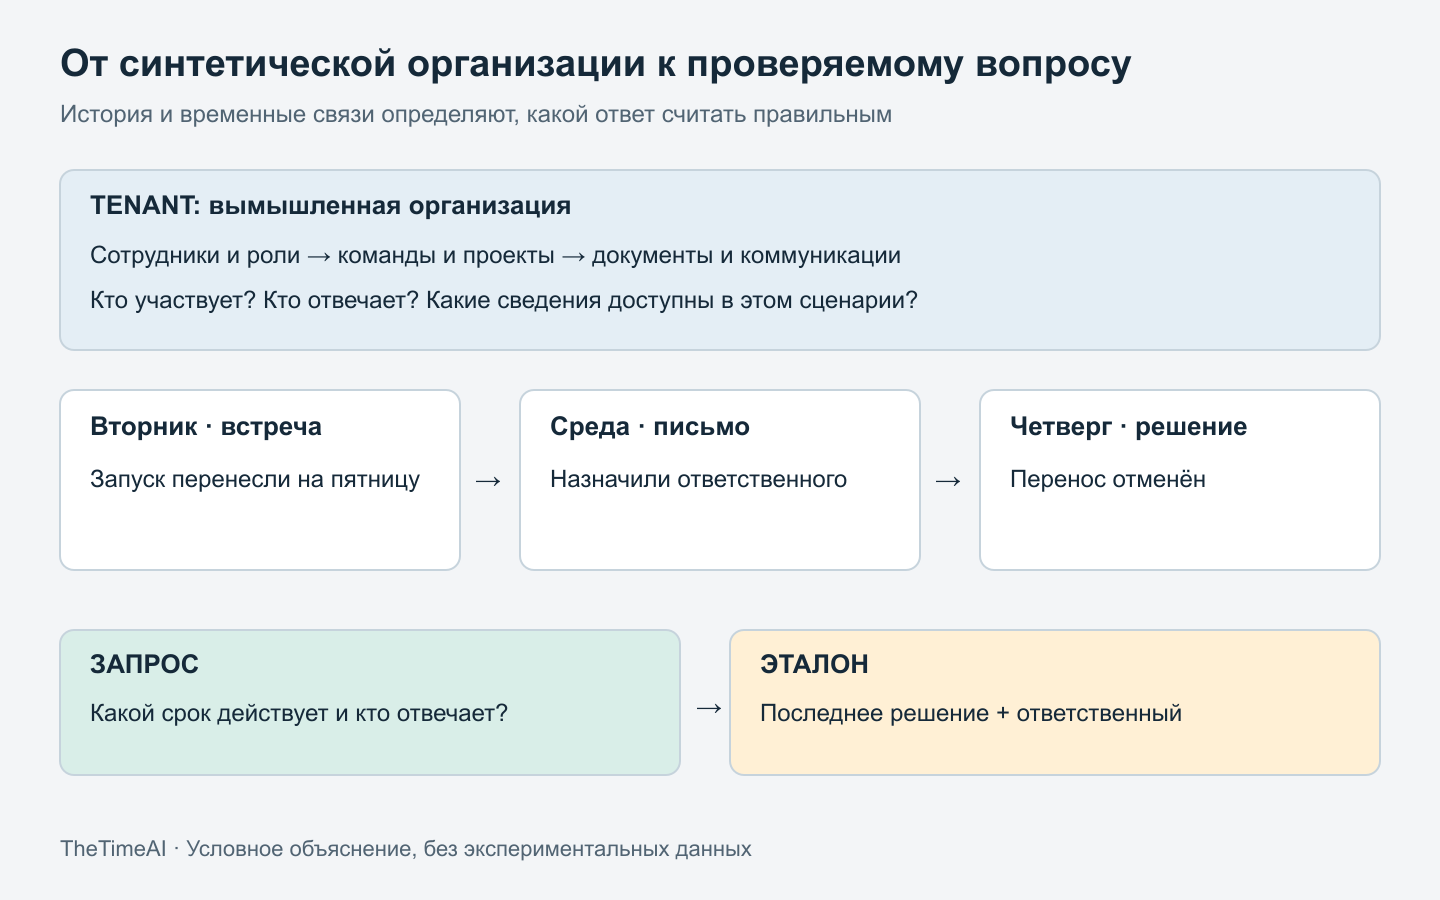
Представим условный редакционный пример, а не данные эксперимента Microsoft. Во вторник команда решила перенести запуск на пятницу, в среду согласовала ответственного, в четверг отменила перенос. Запрос «какой срок действует сейчас и кто отвечает?» требует соединить документы и учесть последнее решение. Если симулятор создаст только гладкие, непротиворечивые отчёты, помощник не встретит здесь трудность, ради которой его собирались проверять.
От естественного запроса к проверяемому эталону
Наличие корпуса ещё не даёт оценочного набора. Microsoft описывает конвейер, который берёт общие рабочие задачи, отбирает подходящие отрасли, добавляет профессиональный контекст, генерирует вопросы с опорой на синтетические данные, делает формулировки естественнее и проверяет точность и уникальность. Такой подход позволяет быстрее создавать варианты, чем ручное написание каждого вопроса. Однако вопрос может звучать убедительно и при этом проверять слишком простую задачу.
Следующее необходимое звено — эталон: какие документы отвечают на запрос, какие факты обязательны и какой временной срез действует. Это редакционное объяснение требований к оценке, а не утверждение о раскрытой Microsoft разметке. В публичной заметке не приведены корпус, полные рубрики оценивания, выборка запросов и распределения результатов, позволяющие самостоятельно восстановить проверку. Поэтому читатель не может проверить, достаточно ли в ней сложных случаев, неоднозначных запросов или вопросов без ответа.
Страница исследовательской группы M365 Research прямо ставит задачу различать сбои модели, поиска, инструментов, среды, данных и оценщиков. Другая группа, Agentic Innovation, описывает создание синтетических tenants со свойствами под конкретную оценку или сценарий. Это полезный контекст: среда должна соответствовать проверяемой задаче. Сами страницы групп не раскрывают дополнительные результаты проекта от 30 октября и не заменяют независимую проверку его методики.
Три проверки вместо одной красивой цифры
Для условной истории запуска разделим проверку на три контрольных вопроса. Первый — поиск, или retrieval: попали ли в контекст помощника нужные документы? Важно найти не только первое решение, но и отменяющее его сообщение. Если поиск пропустил последнее изменение, генератор получает правдоподобную, но устаревшую картину. Такой сбой нельзя уверенно исправить одним требованием к модели «отвечай точнее»: нужно разобраться с найденными источниками.
Второй вопрос — groundedness, то есть опора ответа на предоставленный контекст: добавил ли помощник неподтверждённые сведения? Ответ «запуск в пятницу» может добросовестно пересказывать найденное письмо, хотя поиск пропустил более позднюю отмену. Следовательно, согласованность с контекстом сама по себе не равна правильности относительно всей истории организации. И наоборот, придуманный бюджет будет отдельной проблемой, даже если нужная дата найдена верно.
Третий вопрос — полнота ответа относительно эталона: покрыты ли все обязательные сведения? Если помощник верно назвал действующую дату, но пропустил ответственного, текст может быть обоснованным и одновременно неполным. Это редакционное разложение задачи, а не утверждение, что описанный проект уже использовал конкретные инструменты или пороги. Оно даёт понятную диагностику: менять поиск, ограничивать неподтверждённую генерацию или добиваться покрытия обязательных фактов.
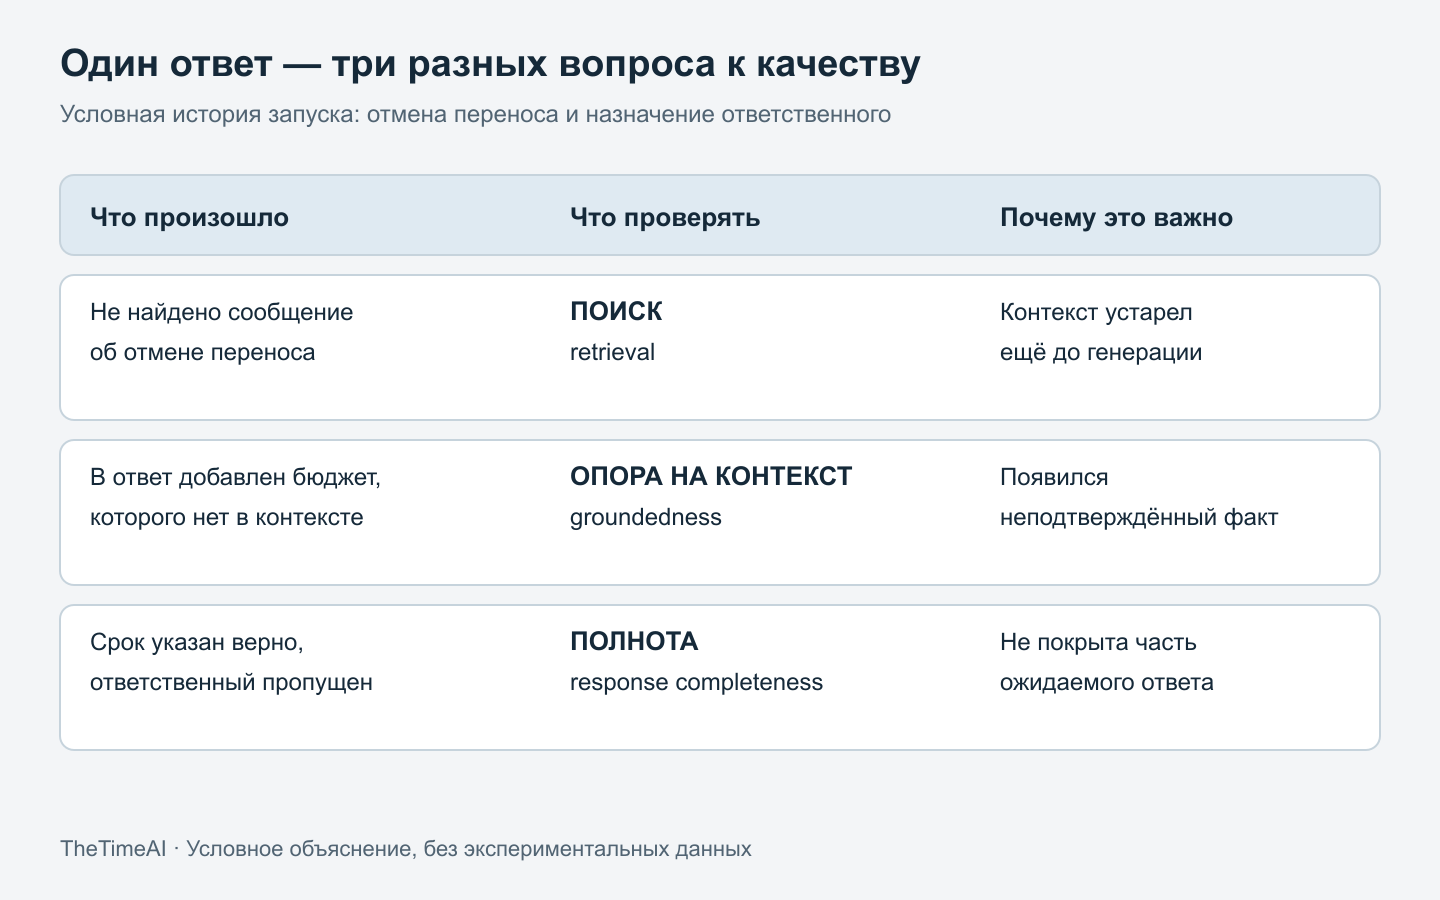
Матрица показывает логические различия, а не результаты тестирования Copilot. На практике оценщики тоже требуют проверки: какие входы им передали, какие критерии выбрали, где они ошибаются и как их решения согласуются с экспертной разметкой. Одно среднее значение может скрывать провал на отменённых решениях при хороших ответах на простые вопросы. Для содержательного сравнения нужны результаты по типам задач и разбор конкретных неудач.
Что именно означают результаты Microsoft
Заявленный рост на 39% относится к внутренней составной метрике качества синтетических данных по сравнению с исходным подходом генерации. Это не рост точности Copilot на 39% и не доля успешно выполненных рабочих задач. Показатели выше 0,9 из 1,0 у некоторых отраслевых сред также описывают качество данных по внутренней системе компании, а не вероятность правильного ответа помощника.
В рамке качества Microsoft перечисляет структурное соответствие, контекстную релевантность, реалистичность поведения и безопасность содержимого. Для каждого критерия нужен свой способ проверки. Правильная иерархия сотрудников ещё не гарантирует естественную переписку, а отсутствие персональных данных не гарантирует полезный набор сложных запросов. Улучшение суммарного показателя без опубликованных весов и распределений нельзя переводить в конкретный выигрыш конечного пользователя.
Компания также оценивает экономию примерно в 100 тысяч долларов на оценочный набор и 300 тысяч долларов по проекту в целом. Это расчёт Microsoft, не независимо подтверждённый финансовый результат. Автоматизация, по её описанию, заменила многодневную ручную работу и позволяет воспроизводить набор по одной конфигурации. Ценность такой повторяемости — в сравнении версий при одинаковых условиях; она не устраняет риск того, что сами условия недостаточно представительны.
Граница полезного вывода
Отказ от реальных клиентских данных на всех этапах — принцип именно описанного проекта Microsoft. Его нельзя читать как общий запрет любых корпоративных данных в оценке ИИ. Синтетический контур облегчает внутреннее повторное использование и регрессионные проверки, но для переноса вывода на конкретную организацию нужно установить, какие свойства её работы воспроизведены и какие остались за пределами симуляции.
Публичная публикация не предоставляет независимой внешней валидации переноса результатов на реальные организации. Авторы относят оценку многоходовых агентных взаимодействий, длительной организационной динамики и систем, совершающих действия, к дальнейшей работе. Из описанного набора нельзя заключить, что помощник уже надёжно проведёт многошаговый процесс или безопасно изменит рабочие записи. Для действий нужны дополнительные критерии результата и допустимости операции.
Agentic Innovation отдельно описывает цикл от диагностики ошибки к ограниченному исправлению и его проверке до внедрения. Это объясняет практическую ценность раздельных оценок: они помогают выбрать, что исправлять, и не сломать прежние сценарии. Но это заявленное направление исследований группы, а не опубликованное доказательство эффективности конкретного синтетического набора. Между испытательной инфраструктурой и надёжностью продукта остаётся проверяемая цепочка, которую нельзя сокращать до одного показателя.
Полезный вывод скромнее обещания универсальной надёжности: Microsoft показывает способ построить повторяемую испытательную среду с организационными и временными связями. Следующий доказательный шаг — раскрыть, какие запросы и эталоны она покрывает, отдельно показать ошибки поиска, обоснованности и полноты и проверить перенос на реальные рабочие условия. До этого синтетическая компания служит инструментом диагностики, а её реалистичность остаётся предпосылкой оценки, которую ещё предстоит связать с качеством корпоративного ИИ.

