Почему поиску мало одного запроса: как ИИ учат собирать разные результаты без долгого рассуждения
Исследователи Google предложили вынести сложный подбор поисковых направлений из времени ответа в обучение компактной модели. Разбираем метод, цифры и границы эксперимента.

Поиск часто должен вернуть не один лучший документ, а осмысленный набор. Запрос «снаряжение для похода» полезно разложить на палатку, спальник, горелку и фонарь, а не показать десять почти одинаковых палаток. В рекомендациях действует та же логика: отдельные элементы должны быть релевантны, но весь список ещё и разнообразен, согласован и достаточно полон.
15 сентября 2026 года Google Research опубликовала разбор Retrieve-for-Train, или R4T, — метода для такого поиска по наборам. Научная работа была загружена на arXiv 6 марта и представлена как статья ICML 2026; свежим поводом стала подробная публикация Google. Авторы предлагают один раз использовать обучение с подкреплением, чтобы найти удачное поведение поиска, затем превратить найденные траектории в синтетические обучающие данные и обучить компактный диффузионный ретривер. Во время пользовательского запроса большая языковая модель уже не должна долго рассуждать и последовательно создавать подзапросы.
Это не универсальная замена поисковику и не доказательство улучшения веб-поиска. Эксперименты проведены на двух специализированных наборах — модных комплектах и музыкальных плейлистах. Их значение в другом: работа показывает конкретный способ «скомпилировать» сложную цель, заданную наградой, в более дешёвую модель для повторяющихся запросов к фиксированной базе.
Зачем поиску веер подзапросов
Классический плотный поиск сопоставляет исходный запрос с объектами в общем пространстве эмбеддингов и выбирает ближайшие. Для широкого намерения этого недостаточно. Ближайшие элементы могут хорошо соответствовать формулировке по отдельности, но повторять один и тот же смысл. Поэтому системы используют fan-out: сначала создают несколько подзапросов, затем объединяют найденное.
Проблема возникает на уровне набора. Разнообразие нельзя измерить у одного результата; оно появляется только при сравнении элементов. То же относится к взаимодополняемости и покрытию намерения. Единственного правильного списка часто нет: для одного запроса подходят несколько разных комплектов. Обычная разметка «запрос — правильный объект» плохо описывает такую цель, а ручная подготовка множества хороших наборов дорога и субъективна.
Можно поручить разложение запроса языковой модели при каждом обращении. Но авторегрессионная модель создаёт токены последовательно, а поиск по каждому подзапросу добавляет вызовы ретривера. Качество можно повышать, генерируя несколько вариантов и выбирая лучший по награде, однако этот Best-of-N ещё сильнее увеличивает задержку. R4T переносит дорогую часть в подготовку модели.
Как устроен Retrieve-for-Train
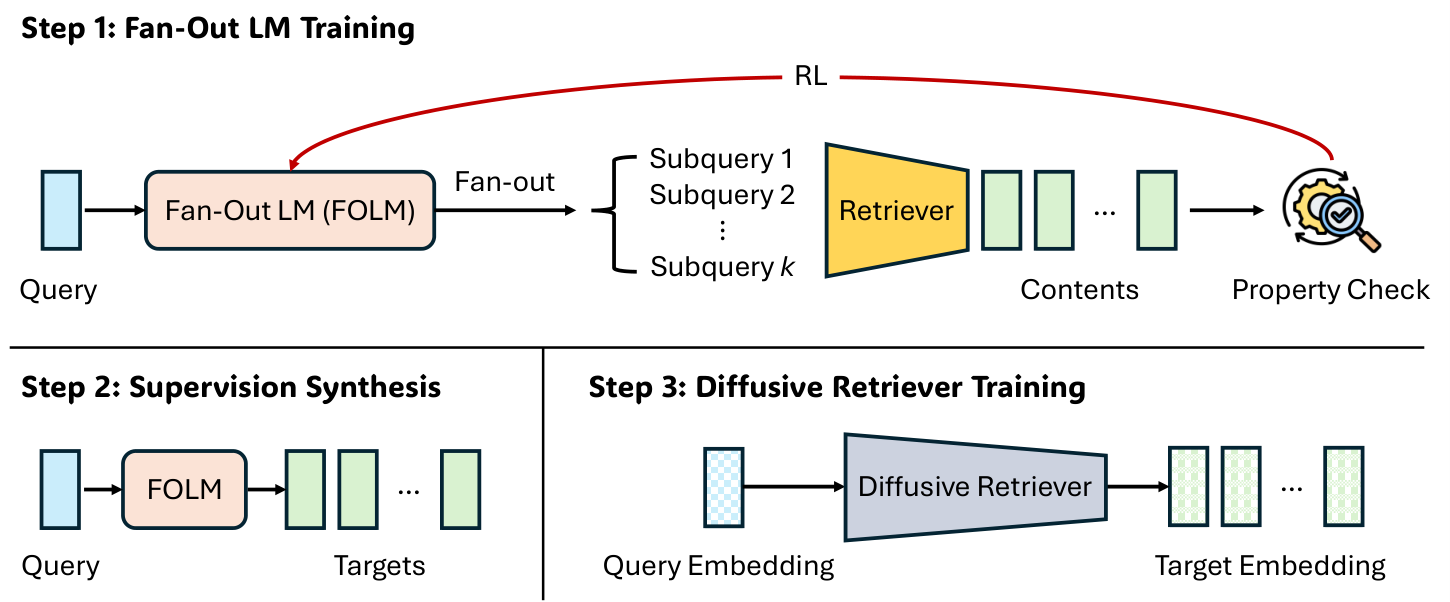
Процесс состоит из трёх стадий. Сначала языковую модель учат создавать десять подзапросов. Каждый вариант выполняется против замороженного ретривера, после чего весь набор получает общую награду. В экспериментах использовались открытые Gemma 3 4B и Qwen 3 4B, а оптимизация строилась на GRPO с дополнительной регуляризацией Soft-PPO.
На второй стадии уже обученная языковая модель многократно создаёт удачные веера поиска. Результаты превращаются в пары «исходный запрос — набор целевых эмбеддингов». Для задачи без единственного эталона целями служат эмбеддинги найденных объектов; для композиционного поиска — эмбеддинги подзапросов, покрывающих элементы слабого эталонного набора. Порядок строк случайно меняют при обучении, потому что сам набор не должен зависеть от позиции элемента.
На третьей стадии эти синтетические пары обучают диффузионную модель на 53,9 млн параметров. Она получает эмбеддинг запроса, восстанавливает сразу несколько направлений поиска из шума и сопоставляет их с объектами базы через ближайших соседей. В отличие от языковой модели, она выдаёт весь набор параллельно в непрерывном пространстве и не генерирует цепочку текстовых подзапросов. Параллельность направлений не означает единственного вычислительного шага: приложение F описывает решатель стохастического дифференциального уравнения с 256 шагами.
Награда должна удержать три цели одновременно
Для открытого поиска авторы складывают три компонента. Groundedness штрафует подзапросы, удалённые от реальных объектов базы. Alignment удерживает их рядом с исходным намерением. Diversity, рассчитанное через Vendi Score, требует, чтобы направления не повторяли друг друга. Базовые веса в работе — 0,6 для привязки к базе и по 0,2 для разнообразия и соответствия запросу.
Абляционный эксперимент показывает, почему одного понятного критерия мало. Только привязка к базе приводит к бессмысленным строкам, которые случайно попадают в выгодную область эмбеддингов. Добавление соответствия запросу без разнообразия ускоряет другой коллапс: модель повторяет почти одинаковые перефразировки. Авторы называют разнообразие и соответствие взаимными противовесами. Это важный результат работы: формально корректная награда по одному показателю может обучить нежелательный обходной путь.
На чём проверяли метод
Первый набор — Polyvore с пользовательскими комплектами одежды. Для открытой задачи использовали 21 888 коллекций, для композиционной — 142 472 отдельных объекта. Изображения и текст сопоставлялись CLIP-подобным энкодером с эмбеддингами размерности 128. Второй набор содержит 8 522 экспертных музыкальных плейлиста и использует совместное пространство музыки и текста MuLan. Музыкальные данные закрыты, поэтому внешний читатель не может полностью воспроизвести эту часть по публикации.
R4T сравнивали с поиском без веера, нулевым созданием подзапросов и Best-of-N, где языковая модель строит пять наборов, а система выбирает лучший по той же награде. Для открытой задачи разнообразие, соответствие и привязку оценивала другая модель по пятибалльной шкале. В основном разделе указана Gemini 2.5 Pro, а в приложении B.1 — Gemini 2.5 Flash. Это внутреннее расхождение документации, которое мешает точно определить конфигурацию оценивания без разъяснения авторов.
Что получилось в экспериментах
В открытом поиске по Polyvore среднее значение из таблицы 1 для R4T-FOLM на Gemma составило 49,1 против 38,5 у нулевого веера и 40,9 у Best-of-N. Для Qwen значения были 42,6, 28,1 и 30,4 соответственно. Это числовой масштаб таблицы авторов, а не непосредственные баллы из пяти: в описании протокола шкала 1–5 указана отдельно, без явного объяснения преобразования. Поэтому здесь сравниваются значения внутри одной таблицы, без собственной нормировки. Диффузионный вариант сохранил высокие показатели разнообразия и соответствия, но для него авторы не считают groundedness тем же способом: он не создаёт промежуточный текстовый подзапрос. Поэтому неполные строки таблицы нельзя превращать в общий средний балл и напрямую сравнивать со всеми колонками R4T-FOLM.
В композиционном поиске по Polyvore R4T-FOLM на Qwen получил Recall@5K 20,9 и Hit@5K 64,6; у исходного Qwen — 10,1 и 33,9. Диффузионный вариант достиг 16,5 и 57,5. Recall@5K показывает, какая доля всех эталонных объектов найдена в пуле из 5000 кандидатов, а Hit@5K — долю запросов, для которых найден хотя бы один эталонный объект. Пул получают, собирая по 500 кандидатов для каждого из десяти направлений. При этом более высокая полнота иногда сопровождалась меньшим разнообразием между запусками. Авторы подчёркивают: эталонный комплект — лишь один допустимый ответ, поэтому более низкий recall не всегда означает худшее качество. Метрики измеряют разные стороны компромисса.
Самое заметное системное преимущество — задержка. Для партии из восьми запросов авторегрессионный fan-out занял около 1,46 секунды, а диффузионный — 0,07 секунды. При партии 1024 значения выросли почти до 50 и 4,21 секунды. В проверенной конфигурации разница составила от 12 до 20 раз. Это измерения конкретной реализации, оборудования и задачи, а не обещание такого ускорения для любого каталога.

Где заканчиваются выводы
Начальная экономия не бесплатна. Сначала требуется многократно запускать обучение с подкреплением, обращаться к ретриверу и вычислять награду. Для очень большой или часто меняющейся базы этот авансовый расход может быть значительным, а синтетические цели придётся обновлять. Метод предполагает и то, что желаемые свойства удаётся выразить числами. Креативность, культурная уместность или субъективная новизна плохо сводятся к одной скалярной функции.
Открытая часть оценки частично зависит от модели-судьи, способной наследовать собственные предпочтения и ошибки. Авторы рандомизировали порядок элементов, задали критерии и требовали объяснение балла, но человеческой оценки в представленном протоколе нет. Кроме того, работа исследует конкретные энкодеры, две предметные области и одну диффузионную архитектуру. Она не показывает качество на вебе, в новостном поиске, юридических документах или каталогах с быстро меняющимся ассортиментом.
Практический смысл исследования
R4T полезно рассматривать как архитектурный шаблон. Если у сервиса есть стабильная специализированная база, повторяющиеся широкие запросы и чёткие свойства хорошего набора, дорогой агент может сначала исследовать варианты и создать обучающие примеры. После этого меньшая модель обслуживает запросы без длинного рассуждения. Такой подход потенциально подходит каталогам, плейлистам, подборкам контента и поиску взаимодополняющих элементов.
Перед внедрением всё равно нужно ответить на четыре вопроса: можно ли измерить качество всего набора; как награда защищена от обходных решений; насколько база меняется после синтеза данных; и подтверждают ли реальные пользователи пользу разнообразия. Ускорение инференса имеет смысл только после проверки этих условий. Исследование Google показывает, что часть дорогого рассуждения действительно можно перенести в обучение, но одновременно демонстрирует цену такого переноса: отдельную модель, собственную систему наград и узкую область, в которой поведение проверено.

