Как сравнить текст двух PDF до и после правки ИИ в Windows
Считаем страницы и показываем построчный diff извлечённого текста локально. С учебными PDF, read-only скриптом и честными границами проверки.
- Программы
- Python 3.12.14 · pypdf 6.10.0
Подробности проверки
- Windows 11
- PowerShell
- Python 3.12.14
- pypdf 6.10.0
- reportlab 4.4.9

ИИ вернул исправленный PDF, и теперь нужно найти заменённые числа, исчезнувшие строки или добавленные страницы. Сравним две локальные копии в Windows: посчитаем страницы, извлечём текст через pypdf и покажем построчный unified diff. Сценарий читает PDF и печатает отчёт в терминал; исходные файлы он не перезаписывает.
Гайд рассчитан на читателя, который уже умеет запускать Python в PowerShell. Результат — список различий извлечённого текста для ручной сверки. Совпадение текста не подтверждает сохранение оформления, изображений, смысла или всех данных PDF. Для начала используйте только учебные документы.
Что понадобится
Нужны Windows, PowerShell, Python 3.12 и заранее установленный pypdf. Учебный генератор дополнительно использует reportlab. В доступной редакционной среде обнаружены Python 3.12.14, pypdf 6.10.0 и reportlab 4.4.9. Это проверка наличия зависимостей, а не подтверждение выполнения всего гайда. Если Python или модуль отсутствует, остановитесь: инструкция не устанавливает программы и не требует API либо загрузки документов в сервис.
python --version
python -c "import pypdf; print(pypdf.__version__)"
python -c "import reportlab; print(reportlab.Version)"
Во всех командах python должен обозначать один и тот же интерпретатор. Если у вас он запускается полным путём, заменяйте python на & "C:\путь\python.exe" в каждом вызове. Команды ниже ориентированы на pypdf 6.10.0. На момент чтения официальная ветка stable показывает документацию 6.21.4; мы используем базовые PdfReader, pages и extract_text и не предлагаем обновление пакета в рамках проверки.
Выберите небольшие доверенные локальные PDF и закройте их редакторы. Не меняйте файлы во время сравнения. Разбор сложного PDF может потребовать много памяти; этот короткий скрипт не ограничивает время или расход RAM и не является безопасной песочницей для произвольных вложений. При зависании остановите процесс Ctrl+C и проверьте документ отдельно.
1. Подготовьте две учебные версии
- Создайте новую пустую рабочую папку и откройте в ней PowerShell. Сохраните следующий код в UTF-8 как make_fixtures.py. Расширение должно быть .py, а не .py.txt.
- Запустите генератор один раз. Он создаст новую подпапку pdf-text-lab и пять PDF. Если такая папка уже есть, код завершится ошибкой до записи: выберите другую пустую рабочую папку. Не подставляйте сюда папку со своими документами.
from pathlib import Path
from reportlab.pdfgen import canvas

root = Path('pdf-text-lab')
root.mkdir(exist_ok=False)
def make(name, lines):
    c = canvas.Canvas(str(root / name))
    for text in lines:
        if text:
            c.drawString(72, 760, text)
        c.showPage()
    c.save()
make('before.pdf', ['Project Aurora', 'Budget: 120'])
make('after.pdf', ['Project Aurora', 'Budget: 150'])
make('added-page.pdf', ['Project Aurora', 'Budget: 150', 'New appendix'])
make('empty-page.pdf', ['Project Aurora', ''])
(root / 'same.pdf').write_bytes((root / 'before.pdf').read_bytes())
print('Created five synthetic PDFs in', root)
python .\make_fixtures.pyИсходник содержит две страницы: Project Aurora и Budget: 120. В after.pdf бюджет равен 150, same.pdf — точная копия исходника, added-page.pdf содержит третью страницу, empty-page.pdf — пустую вторую. Это синтетические английские строки без личных данных. Генератор создаёт примеры; он отличается от проверяющего, который ничего не записывает.
2. Сохраните проверяющий скрипт
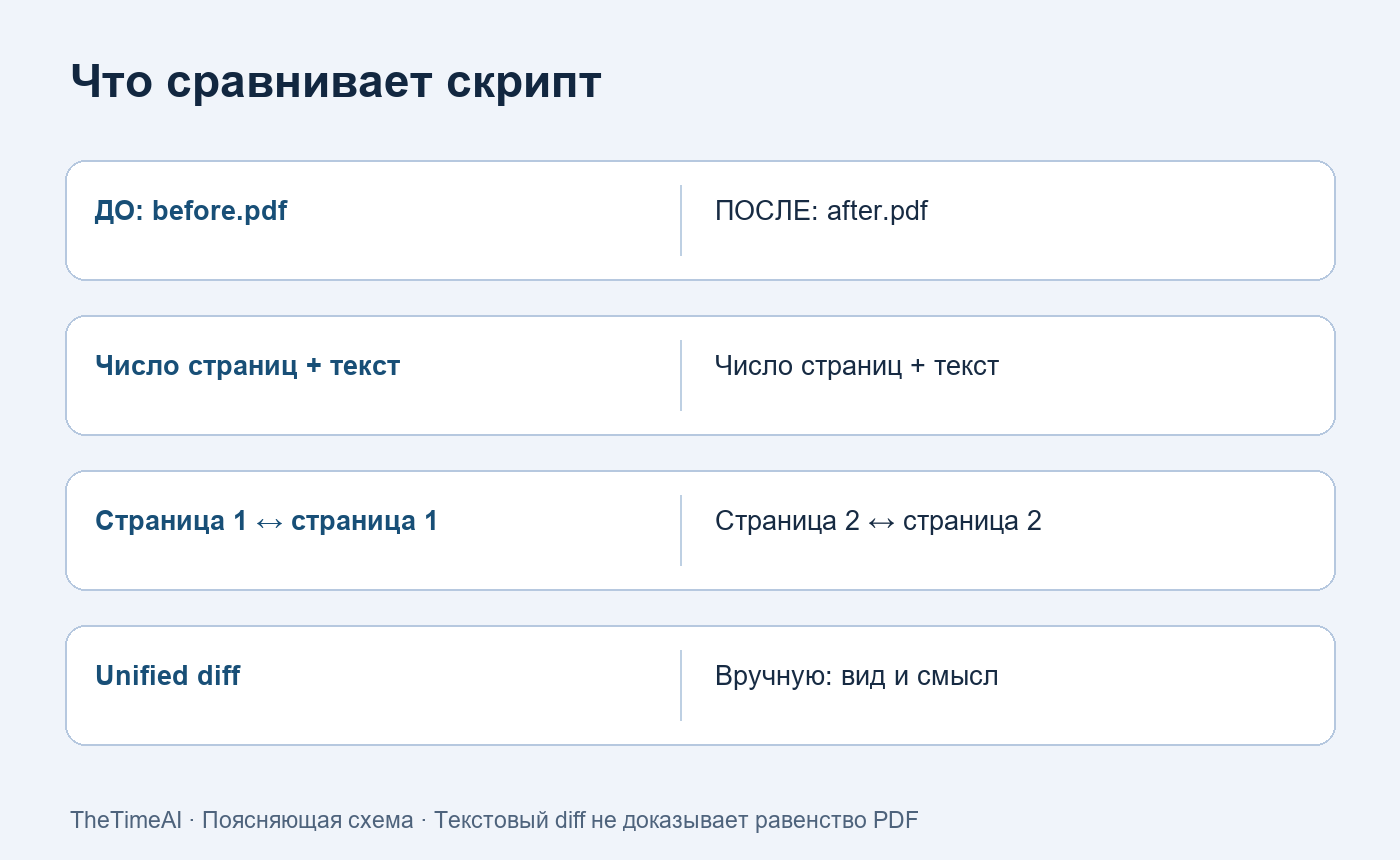
Сохраните весь код как compare_pdf_text.py рядом с make_fixtures.py, в UTF-8. Он открывает каждый файл в режиме rb, использует строгий разбор PDF, отклоняет шифрование и не вызывает PdfWriter. Нумерация PAGE относится к позиции страницы в файле, начиная с 1, а не к напечатанным номерам.
import sys
from pathlib import Path
from difflib import unified_diff
from pypdf import PdfReader

def extract(name):
    path = Path(name)
    if not path.is_file():
        raise ValueError('not a regular file: ' + name)
    with path.open('rb') as stream:
        reader = PdfReader(stream, strict=True)
        if reader.is_encrypted:
            raise ValueError('encrypted PDF: ' + name)
        pages = []
        for page in reader.pages:
            pages.append(page.extract_text() or '')
    return pages

def main():
    if len(sys.argv) != 3:
        raise ValueError('usage: python compare_pdf_text.py BEFORE.pdf AFTER.pdf')
    before, after = (extract(name) for name in sys.argv[1:])
    print('PAGES', len(before), '->', len(after))
    empty = False
    for label, pages in [('BEFORE', before), ('AFTER', after)]:
        for number, text in enumerate(pages, 1):
            if not text.strip():
                empty = True
                print('NEEDS-MANUAL: empty extracted text', label, 'page', number)
    changed = len(before) != len(after)
    for index in range(max(len(before), len(after))):
        left = before[index] if index < len(before) else ''
        right = after[index] if index < len(after) else ''
        if left != right:
            changed = True
            print('PAGE', index + 1)
            # Preserve whitespace and Unicode; normalize no text beyond line splitting.
            for line in unified_diff(left.splitlines(), right.splitlines(),
                                     fromfile='before/page-' + str(index + 1),
                                     tofile='after/page-' + str(index + 1), lineterm=''):
                print(line)
            if left.splitlines() == right.splitlines():
                print('LINE-ENDINGS-ONLY: extracted strings differ')
    print('TEXT-DIFF' if changed else 'EXTRACTED-TEXT-SAME')
    print('MANUAL: inspect both PDFs; no visual or semantic equivalence check.')
    return 2 if empty else (1 if changed else 0)

try:
    sys.exit(main())
except Exception as error:
    print('NEEDS-MANUAL:', type(error).__name__, str(error), file=sys.stderr)
    sys.exit(2)
3. Запустите сравнение и проверьте неизменность PDF
Выполните весь блок целиком. Снимки SHA-256 остаются в переменных PowerShell, отчёт — в терминале. Код возврата сохраняется сразу после Python. Пустой вывод Compare-Object означает совпадение путей и хешей двух PDF между этими снимками; это отдельная проверка байтов, а не оценка содержания.
$pdfPair = @(".\pdf-text-lab\before.pdf", ".\pdf-text-lab\after.pdf")
$beforeHashes = @($pdfPair | Get-FileHash -Algorithm SHA256 | ForEach-Object { "$($_.Path)|$($_.Hash)" } | Sort-Object)
python .\compare_pdf_text.py $pdfPair[0] $pdfPair[1]
$compareExit = $LASTEXITCODE
$afterHashes = @($pdfPair | Get-FileHash -Algorithm SHA256 | ForEach-Object { "$($_.Path)|$($_.Hash)" } | Sort-Object)
Compare-Object -ReferenceObject $beforeHashes -DifferenceObject $afterHashes
$compareExit
Для этой учебной пары ожидаются PAGES 2 -> 2, PAGE 2, строка -Budget: 120, строка +Budget: 150, итог TEXT-DIFF и код 1. Это ожидаемый результат обнаружения правки. Строки --- и +++ — заголовки файлов в diff; @@ задаёт диапазоны строк. Обычный минус обозначает удаление, плюс — добавление. Номера строк относятся к извлечённому тексту страницы.
4. Разберите остальные исходы

| Вывод / код | Что означает |
|---|---|
| EXTRACTED-TEXT-SAME / 0 | Совпали число страниц и извлечённые строки, нет страниц с пустым текстом. Оформление, изображения и смысл не проверены. |
| TEXT-DIFF / 1 | Различается число страниц или извлечённый текст. Проверьте пары минус/плюс и сами страницы. |
| NEEDS-MANUAL / 2 | Ошибка чтения, неподходящий путь, шифрование или хотя бы одна страница без извлечённого текста. Итог не считается успешной проверкой. |
- Замените after.pdf на same.pdf в $pdfPair и повторите весь блок со снимками. Ожидаются EXTRACTED-TEXT-SAME и код 0.
- Повторите с added-page.pdf: ожидаются PAGES 2 -> 3, TEXT-DIFF и код 1. Для проверки удаления поменяйте эту пару местами: число страниц станет 3 -> 2.
- Повторите с empty-page.pdf: ожидается предупреждение о странице 2 файла AFTER и код 2. Даже если напечатан TEXT-DIFF, пустое извлечение требует ручной проверки.
Если после вставки или удаления страницы изменилось много последующих страниц, причина может быть в сдвиге нумерации: скрипт сопоставляет первую с первой, вторую со второй. Он не ищет соответствующие разделы и не выравнивает страницы по смыслу. При различии только окончаний строк он выводит LINE-ENDINGS-ONLY; пробелы и Unicode намеренно не нормализуются.
5. Сравните свои локальные копии
- Сохраните оригинал отдельно. В рабочей папке разместите две доверенные копии: до и после правки. Сначала откройте обе и убедитесь, что это нужные документы.
- В $pdfPair укажите два точных пути в кавычках: сначала исходник, затем новую версию. Повторите весь блок запуска и сравнения хешей. Не перезаписывайте исходные PDF отчётом.
- Проверьте в обоих PDF изменённые числа, даты, имена, отрицания и оговорки. На страницах с таблицами сверяйте пары «название — значение», заголовки и единицы. Отдельно осмотрите изображения и оформление.
- Если отчёт нужен на диске, сохраните его отдельным новым файлом вне папки с оригиналами. Он может содержать личные данные из обеих версий; перед передачей прочитайте его.
Где метод останавливается
Пустой текст возможен у пустой страницы, скана без текстового слоя или при проблеме извлечения. Скрипт не различает эти причины. pypdf не выполняет OCR; скан с уже существующим OCR-слоем может вернуть ошибочные буквы, которые библиотека не исправляет. Наличие непустого текста на каждой странице тоже не доказывает полноту: часть документа может остаться картинкой.
PDF хранит расположенные на странице элементы. Колонки, таблицы, колонтитулы, переносы, лигатуры и шрифтовые кодировки могут дать неожиданный порядок строк или символов. Поэтому отличие diff иногда вызвано экспортом, а совпадение не гарантирует верных связей между значениями. Текстовый слой может не совпадать с видимым изображением; сверяйте важные строки на экране.
Шифрованные PDF отклоняются целиком, включая варианты с пустым паролем: сценарий не запрашивает пароль и не пытается снять защиту. При повреждённом или нестандартном PDF strict=True может остановить разбор даже там, где просмотрщик открывает файл. Не переключайте strict ради зелёного результата: запросите корректный экспорт и повторите проверку отдельно. Ошибка FileNotFoundError или not a regular file обычно требует сверить имя и рабочую папку; ModuleNotFoundError — вернуться к требованиям.
Скрипт не проверяет вложения, подписи, формы, ссылки, метаданные, корректность PDF по стандарту, безопасность содержимого и семантическую равнозначность. Не отправляйте отчёт ИИ с просьбой подтвердить полную сохранность документа на основании одного diff.
Завершение и отмена
Проверяющий не вносит правок в PDF, поэтому откатывать его действие над документом нечего. Правки ИИ принимайте только после ручной сверки; для отмены используйте отдельно сохранённый оригинал. Учебные PDF и два .py-файла можно удалить через Проводник после проверки, что это именно созданные вами примеры.

