Как посмотреть внешние связи и состав DOCX перед передачей ИИ в Windows
Локально перечисляем части DOCX и цели relationships, не открывая Word и вложения. С синтетическими примерами и ограниченным readonly-скриптом для Python 3.12.
- Программы
- Python 3.12.14
Подробности проверки
- Windows
- PowerShell 7.6.5
- Python 3.12.14 (MSC v.1944, 64-bit AMD64)

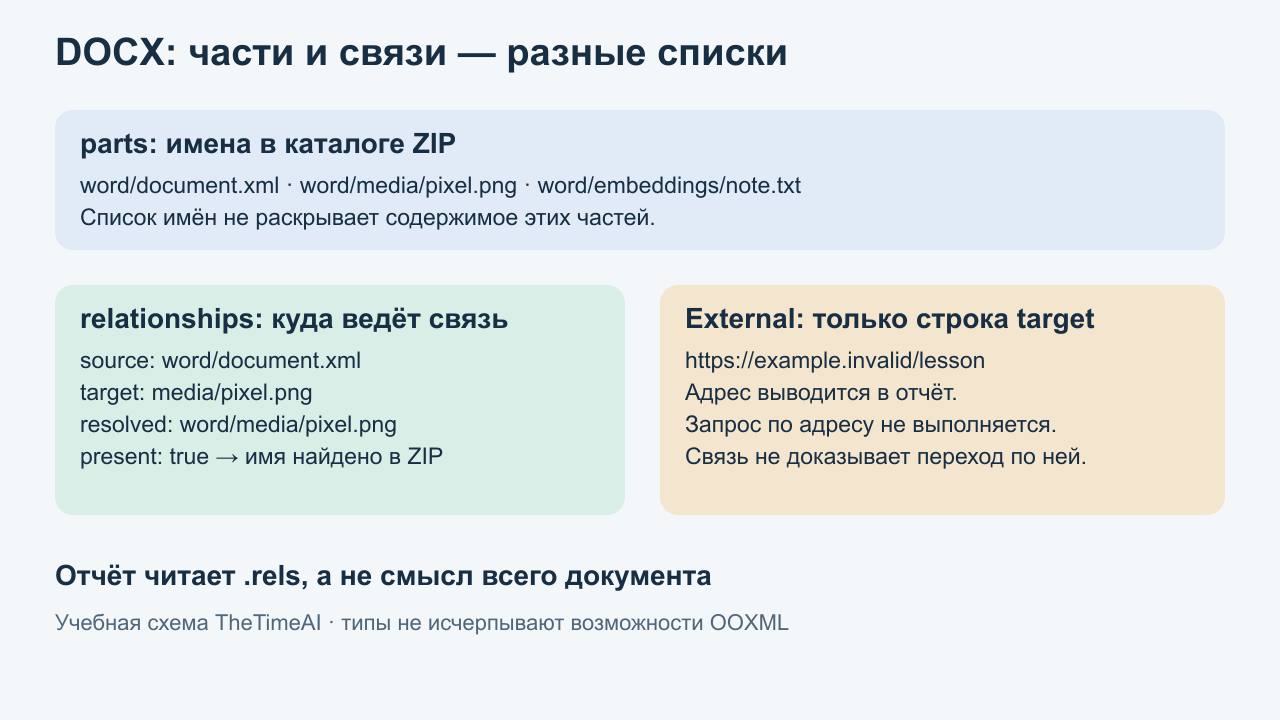
Перед отправкой документа в ИИ полезно понять, что находится внутри файла. Видимая страница Word не показывает весь состав DOCX: в контейнере могут быть отдельные части и связи с внутренними файлами или внешними адресами. Ниже мы построим локальный список имён частей и записей relationships, не открывая Word и не переходя по ссылкам.
Это учебная инвентаризация для собственных небольших документов известного происхождения. Она не предназначена для подозрительных вложений из писем. Модуль ElementTree в документации Python прямо предупреждает о рисках специально сконструированного XML. Ограничения скрипта уменьшают объём чтения, но не превращают его в защитную песочницу.
Что получится и чего отчёт не доказывает
Сначала используем искусственные DOCX-контейнеры без личных данных. Получим JSON с массивами parts и relationships. В parts попадут имена и заявленные размеры ZIP-записей, включая имена под word/media и word/embeddings, если они есть. В relationships — источник связи, её полный тип, режим и цель. Содержимое вложений скрипт не разбирает и не извлекает.
Скрипт не ищет персональные данные, не удаляет метаданные, не проверяет вирусы и не гарантирует безопасное открытие документа. Он не находит все адреса, напечатанные в тексте, полях Word или иных XML-частях. Отсутствие External в отчёте не означает, что документ можно безоговорочно передавать ИИ.
Что потребуется
- Windows и PowerShell; уже установленный Python 3.12. Новое ПО и пакеты устанавливать не нужно.
- Новая учебная папка; сначала только синтетические файлы из генератора ниже.
- Для последующего собственного опыта — отдельная копия небольшого DOCX известного происхождения без секретов и личных данных. Не используйте единственный экземпляр рабочего документа.
1. Проверьте Python и создайте учебную папку
Откройте PowerShell в папке, где можно создавать учебные файлы. Если команда python не найдена или открывает Microsoft Store, остановитесь. Если Python 3.12 уже установлен по известному вам полному пути, замените значение $DocxPython этим путём; остальной код использует ту же переменную. Команда проверки ниже должна завершиться с кодом 0.
$DocxPython = 'python'
& $DocxPython -c "import sys; print(sys.version); sys.exit(0 if sys.version_info[:2] == (3,12) else 2)"
if ($LASTEXITCODE -ne 0) { throw 'Нужен уже установленный Python 3.12' }
$DocxWork = Join-Path (Get-Location) ('docx-inventory-' + [guid]::NewGuid().ToString('N'))
New-Item -ItemType Directory -Path $DocxWork -ErrorAction Stop | Out-Null
Set-Location -LiteralPath $DocxWork
Get-Location
2. Создайте учебные контейнеры
Выполните notepad .\make_docx_fixtures.py. Вставьте весь код и сохраните файл в UTF-8 с точным расширением .py. Генератор создаёт четыре файла в новой подпапке docx-fixtures. Это минимальные искусственные контейнеры для проверки структуры: корректность их отображения в Word не проверяется. Изображение — маленькая тестовая картинка, note.txt — безобидная строка; это не настоящий OLE-объект. Не открывайте файлы в Word для выполнения этого урока.
"""Create only synthetic DOCX-shaped inventory fixtures; never opens Word."""
import base64
import sys
from pathlib import Path
from zipfile import ZipFile, ZIP_DEFLATED

P = 'http://schemas.openxmlformats.org/package/2006/relationships'
R = 'http://schemas.openxmlformats.org/officeDocument/2006/relationships/'
CT = '''<Types xmlns="http://schemas.openxmlformats.org/package/2006/content-types"><Default Extension="rels" ContentType="application/vnd.openxmlformats-package.relationships+xml"/><Default Extension="xml" ContentType="application/xml"/><Default Extension="txt" ContentType="text/plain"/><Default Extension="png" ContentType="image/png"/><Override PartName="/word/document.xml" ContentType="application/vnd.openxmlformats-officedocument.wordprocessingml.document.main+xml"/></Types>'''
DOC = '''<w:document xmlns:w="http://schemas.openxmlformats.org/wordprocessingml/2006/main"><w:body><w:p><w:r><w:t>Synthetic inventory lesson only</w:t></w:r></w:p><w:sectPr/></w:body></w:document>'''
ROOT = f'<Relationships xmlns="{P}"><Relationship Id="rId1" Type="{R}officeDocument" Target="word/document.xml"/></Relationships>'
EMPTY = f'<Relationships xmlns="{P}"/>'
EXAMPLE = f'''<Relationships xmlns="{P}"><Relationship Id="rId1" Type="{R}hyperlink" Target="https://example.invalid/lesson" TargetMode="External"/><Relationship Id="rId2" Type="{R}image" Target="media/pixel.png"/><Relationship Id="rId3" Type="{R}package" Target="embeddings/note.txt"/><Relationship Id="rId4" Type="urn:thetimeai:lesson:unknown" Target="../customXml/item.xml"/></Relationships>'''
folder = Path('docx-fixtures')
try:
    folder.mkdir(exist_ok=False)
except FileExistsError:
    print('STOP: docx-fixtures already exists', file=sys.stderr)
    sys.exit(2)
png = base64.b64decode('iVBORw0KGgoAAAANSUhEUgAAAAEAAAABCAQAAAC1HAwCAAAAC0lEQVR42mP8/x8AAwMCAO+jRZkAAAAASUVORK5CYII=')
for name, rels in (('clean.docx', EMPTY), ('example.docx', EXAMPLE), ('broken-xml.docx', '<Relationships>')):
    parts = {'[Content_Types].xml': CT, '_rels/.rels': ROOT, 'word/document.xml': DOC, 'word/_rels/document.xml.rels': rels}
    if name == 'example.docx':
        parts.update({'word/media/pixel.png': png, 'word/embeddings/note.txt': 'SYNTHETIC NOTE', 'customXml/item.xml': '<lesson/>'})
    with ZipFile(folder / name, 'x', compression=ZIP_DEFLATED) as archive:
        for part, data in parts.items():
            archive.writestr(part, data)
    print(folder / name)

(folder / 'not-zip.docx').write_bytes(b'SYNTHETIC NOT A ZIP')
print(folder / 'not-zip.docx')
& $DocxPython .\make_docx_fixtures.py
$DocxMakeExit = $LASTEXITCODE
if ($DocxMakeExit -ne 0) { throw 'Генератор не завершился' }
Get-ChildItem -LiteralPath .\docx-fixtures | Select-Object Name, Length
Ожидаются clean.docx, example.docx, broken-xml.docx и not-zip.docx. Повторный запуск в той же папке должен остановиться: существующую docx-fixtures генератор не перезаписывает. Для нового опыта создайте новую учебную папку первым шагом.
3. Сохраните инспектор
Выполните notepad .\inspect_docx.py, вставьте следующий код полностью и сохраните в UTF-8. Он использует только стандартную библиотеку. Четыре короткие метки hyperlink, image, oleObject и package соответствуют точным URI из constants.py официального проекта python-docx. Это опора на реализацию библиотеки, а не утверждение о полной поддержке всех вариантов OOXML.
"""Bounded read-only DOCX ZIP/relationship inventory. No target fetching."""
import argparse
import hashlib
import io
import json
import posixpath
import re
import sys
import zipfile
import zlib
from pathlib import Path
from urllib.parse import urlsplit
from xml.etree import ElementTree as ET

MAX_FILE = 10 * 1024 * 1024
MAX_ENTRIES = 1000
MAX_PART = 10 * 1024 * 1024
MAX_TOTAL = 40 * 1024 * 1024
MAX_XML = 1024 * 1024
MAX_XML_TOTAL = 4 * 1024 * 1024
NS = 'http://schemas.openxmlformats.org/package/2006/relationships'
RT = 'http://schemas.openxmlformats.org/officeDocument/2006/relationships/'
KNOWN = {RT + x: x for x in ('hyperlink', 'image', 'oleObject', 'package')}

class Stop(Exception):
    pass

def require(ok, message):
    if not ok:
        raise Stop(message)

def member_ok(name):
    require(0 < len(name) <= 512 and not any(ord(c) < 32 for c in name), 'member name length/control')
    require(not name.startswith('/') and '\\' not in name and ':' not in name, 'member path form')
    require(all(p not in ('', '.', '..') for p in name.split('/')), 'member path components')

def xml_root(data):
    require(len(data) <= MAX_XML, 'XML size limit')
    require(b'\x00' not in data, 'only UTF-8 XML supported')
    text = data.decode('utf-8-sig')
    enc = re.match(r'''\s*<\?xml\b[^>]*\bencoding\s*=\s*['"]([^'"]+)''', text, re.I)
    require(not enc or enc[1].lower() in ('utf-8', 'utf8'), 'XML encoding')
    require(not re.search(r'<!\s*(DOCTYPE|ENTITY)\b', text, re.I), 'DTD/ENTITY unsupported')
    root = ET.fromstring(text)
    require(sum(1 for _ in root.iter()) <= 5000, 'XML node limit')
    return root

def source_part(name):
    if name == '_rels/.rels':
        return ''
    folder, filename = posixpath.split(name)
    require(posixpath.basename(folder) == '_rels' and filename.endswith('.rels'), 'rels path form')
    owner = posixpath.join(posixpath.dirname(folder), filename[:-5])
    member_ok(owner)
    return owner

def internal_target(owner, target):
    require(not any(c in target for c in ('\\', '%', '?', '#')), 'complex internal target unsupported')
    uri = urlsplit(target)
    require(not uri.scheme and not uri.netloc, 'internal target has scheme/host')
    components = [] if target.startswith('/') else posixpath.dirname(owner).split('/')
    components = [p for p in components if p]
    for p in target.split('/'):
        if p in ('', '.'):
            continue
        if p == '..':
            require(bool(components), 'target leaves package root')
            components.pop()
        else:
            components.append(p)
    result = '/'.join(components)
    member_ok(result)
    return result

def inspect(path):
    require(path.is_file() and not path.is_symlink(), 'regular file required')
    require(path.stat().st_size <= MAX_FILE, 'archive exceeds 10 MiB')
    with path.open('rb') as stream:
        data = stream.read(MAX_FILE + 1)
    require(len(data) <= MAX_FILE, 'archive exceeds 10 MiB')
    report = {'sha256': hashlib.sha256(data).hexdigest(), 'parts': [], 'relationships': []}
    with zipfile.ZipFile(io.BytesIO(data), 'r') as z:
        infos = z.infolist()
        require(len(infos) <= MAX_ENTRIES, 'entry count exceeds 1000')
        names = set()
        total = 0
        for info in infos:
            require(not info.is_dir(), 'directory entries unsupported')
            member_ok(info.orig_filename)
            member_ok(info.filename)
            require(info.filename not in names, 'duplicate ZIP name')
            names.add(info.filename)
            require(not info.flag_bits & 1, 'encrypted ZIP unsupported')
            require((info.external_attr >> 16) & 0o170000 != 0o120000, 'ZIP symlink unsupported')
            require(info.compress_type in (zipfile.ZIP_STORED, zipfile.ZIP_DEFLATED), 'compression unsupported')
            require(info.file_size <= MAX_PART, 'part exceeds 10 MiB')
            require(not info.file_size or (info.compress_size > 0 and info.file_size <= info.compress_size * 100), 'compression ratio exceeds 100:1')
            total += info.file_size
            require(total <= MAX_TOTAL, 'declared total exceeds 40 MiB')
            report['parts'].append({'name': info.filename, 'bytes': info.file_size})
        require({'[Content_Types].xml', '_rels/.rels', 'word/document.xml'} <= names, 'expected DOCX parts absent')
        xml_bytes = 0
        for name in sorted(n for n in names if n.endswith('.rels')):
            owner = source_part(name)
            require(not owner or owner in names, 'rels source part absent')
            info = z.getinfo(name)
            xml_bytes += info.file_size
            require(info.file_size <= MAX_XML and xml_bytes <= MAX_XML_TOTAL, 'relationship XML budget exceeded')
            with z.open(info) as stream:
                payload = stream.read(MAX_XML + 1)
            root = xml_root(payload)
            require(root.tag == '{' + NS + '}Relationships', 'unexpected relationship namespace/root')
            ids = set()
            for rel in root:
                require(rel.tag == '{' + NS + '}Relationship' and not list(rel), 'unexpected relationship element')
                require(set(rel.attrib) <= {'Id', 'Type', 'Target', 'TargetMode'}, 'unexpected relationship attributes')
                rid, typ, target = (rel.get(k, '') for k in ('Id', 'Type', 'Target'))
                require(all(0 < len(v) <= 2048 for v in (rid, typ, target)), 'relationship field length')
                require(rid not in ids, 'duplicate relationship Id')
                ids.add(rid)
                mode = rel.get('TargetMode', 'Internal')
                require(mode in ('Internal', 'External'), 'unexpected TargetMode')
                row = {'source': owner or '/', 'id': rid, 'kind': KNOWN.get(typ, 'OTHER'), 'type': typ, 'mode': mode, 'target': target}
                if mode == 'Internal':
                    resolved = internal_target(owner, target)
                    row.update(resolved=resolved, present=resolved in names)
                report['relationships'].append(row)
                require(len(report['relationships']) <= 2000, 'relationship count exceeds 2000')
    report['parts'].sort(key=lambda x: x['name'])
    report['note'] = 'Inventory only; no document/attachment content scan; no target requests.'
    return report

def main():
    parser = argparse.ArgumentParser(description=__doc__)
    parser.add_argument('docx', type=Path)
    args = parser.parse_args()
    try:
        result = inspect(args.docx)
    except (Stop, OSError, ValueError, ET.ParseError, zipfile.BadZipFile, RuntimeError, NotImplementedError, EOFError, zlib.error) as error:
        print('STOP: ' + ascii(str(error)), file=sys.stderr)
        return 2
    # ASCII escapes prevent terminal control characters from becoming commands/links.
    print(json.dumps(result, ensure_ascii=True, indent=2))
    return 0

if __name__ == '__main__':
    sys.exit(main())
4. Постройте отчёт и сравните хеш файла
Сохраните код завершения сразу после запуска Python. Проверка SHA-256 до и после позволяет заметить изменение входной копии за время опыта; сам инспектор открывает её только для чтения. Сначала запустите пример без перенаправления в файл: весь JSON будет виден в PowerShell.
$DocxInput = '.\docx-fixtures\example.docx'
$DocxBefore = (Get-FileHash -LiteralPath $DocxInput -Algorithm SHA256).Hash
& $DocxPython .\inspect_docx.py $DocxInput
$DocxInspectExit = $LASTEXITCODE
$DocxAfter = (Get-FileHash -LiteralPath $DocxInput -Algorithm SHA256).Hash
[pscustomobject]@{ ExitCode = $DocxInspectExit; InputUnchanged = ($DocxBefore -eq $DocxAfter) }
if ($DocxInspectExit -ne 0 -or $DocxBefore -ne $DocxAfter) { throw 'Инвентаризация не подтверждена' }
Для example.docx ожидаются 7 записей parts и 5 записей relationships, ExitCode = 0 и InputUnchanged = True. Конкретный SHA может отличаться при новом создании ZIP, поэтому сравнивайте свой хеш до и после, а не с редакционным значением.
| Поле или запись | Как понимать |
|---|---|
| source: / | Связь уровня пакета из _rels/.rels. |
| mode: External | В target напечатана цель. Скрипт не обращается к ней: в примере это https://example.invalid/lesson. |
| kind: image; target: media/pixel.png | Относительная цель от word/document.xml разрешается в word/media/pixel.png. Тип связи не доказывает формат байтов изображения. |
| kind: package; target: embeddings/note.txt | Есть запись связи с такой меткой. Содержимое note.txt не читается; настоящий тип вложения не проверяется. |
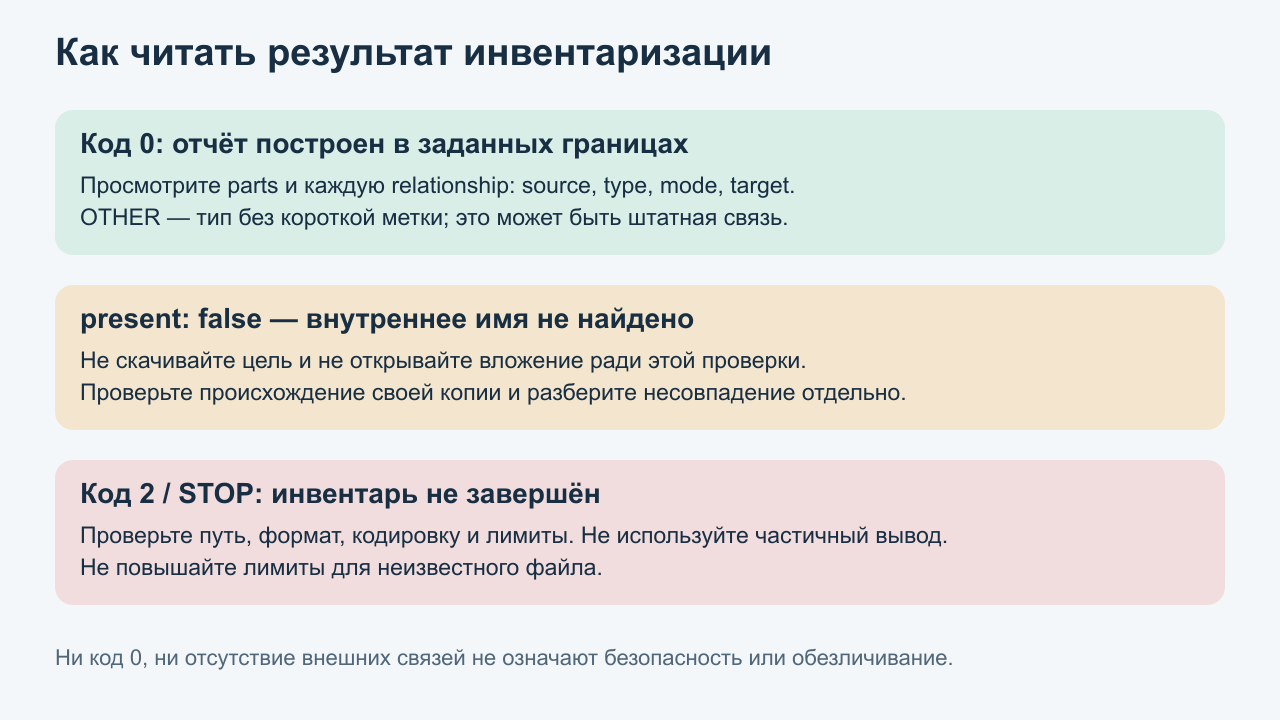
| kind: OTHER | Тип без короткой метки. Штатный officeDocument и искусственный неизвестный тип тоже получат OTHER: это не диагноз. Полный URI остаётся в type. |
| present: true / false | Внутреннее имя найдено / не найдено в каталоге ZIP. Это не проверка CRC, корректности или безопасности содержимого. |
В примере относительный target ../customXml/item.xml от word/document.xml ведёт к customXml/item.xml. Цель с начальным / трактуется от корня пакета, а попытка уйти выше корня вызывает STOP. Внутренние цели с процентным кодированием, параметрами, фрагментом или обратной косой чертой сознательно не поддерживаются. Внешние цели сохраняются строками без нормализации и без сетевых запросов.
5. Проверьте обычный и ошибочные примеры
& $DocxPython .\inspect_docx.py .\docx-fixtures\clean.docx
$DocxCleanExit = $LASTEXITCODE
& $DocxPython .\inspect_docx.py .\docx-fixtures\broken-xml.docx
$DocxXmlExit = $LASTEXITCODE
& $DocxPython .\inspect_docx.py .\docx-fixtures\not-zip.docx
$DocxZipExit = $LASTEXITCODE
[pscustomobject]@{ Clean = $DocxCleanExit; BrokenXml = $DocxXmlExit; NotZip = $DocxZipExit }
Ожидается Clean = 0, BrokenXml = 2 и NotZip = 2. У clean.docx будет только корневая связь officeDocument с меткой OTHER. У ошибочных файлов появится STOP, полноценного JSON-отчёта не будет. Код 0 обозначает завершение именно ограниченного инвентаря; код 2 — отсутствие результата проверки. Не делайте вывод «ссылок нет» из ошибки.
Лимиты и типичные причины остановки
Лимиты этого учебного скрипта: вход до 10 МиБ, до 1000 ZIP-записей, одна объявленная распакованная часть до 10 МиБ, сумма до 40 МиБ и коэффициент сжатия каждой записи до 100:1. XML связей ограничен 1 МиБ на часть и 4 МиБ суммарно, до 5000 XML-элементов на часть и 2000 связей на пакет. Это выбранные редакцией пределы, а не стандарт безопасности DOCX.
Инспектор принимает только ZIP Stored/Deflate и UTF-8 XML связей, отказывает при DTD/ENTITY, зашифрованных записях, дубликатах имён, символических ссылках, записях каталогов и неподдерживаемых путях. Ищутся ожидаемые имена [Content_Types].xml, _rels/.rels и word/document.xml, но содержимое двух первых XML-документов, кроме .rels, и валидность DOCX целиком не проверяются. Необычное пространство имён .rels, неверный TargetMode или повреждённый XML тоже дают STOP. Strict-вариант OOXML не обещан.
Если Python не запускается, исправьте путь к уже установленной версии. Если файл не найден, проверьте Get-Location и точное имя. При STOP из-за размера, сжатия или неподдерживаемой конструкции не повышайте лимиты ради прохождения неизвестного документа. Для собственного сложного файла нужен отдельный проверенный процесс.
Как применить результат к своей копии
- После учебного опыта можно повторить шаг 4, заменив только $DocxInput на путь к отдельной копии собственного DOCX известного происхождения.
- Просмотрите все имена parts, включая неожиданные части вне word/media и word/embeddings, и каждую внешнюю цель.
- Неожиданная связь или часть — повод отложить передачу и уточнить её назначение у автора документа.
- Не открывайте и не загружайте вложение только ради проверки этого списка.
Отчёт сам может содержать внутренние адреса, имена файлов и другие чувствительные строки. Храните его локально и не отправляйте в ИИ автоматически. Этот метод не проверяет текст, комментарии, историю изменений, свойства, изображения, поля и вложения на конфиденциальность. Если задача требует передать только фрагмент текста, отдельно подготовьте и вручную проверьте нужную копию; инвентарь не заменяет такую проверку.
Завершение и отмена учебных изменений
Исходный DOCX не изменяется, откат для него не требуется. Когда опыт закончен, проверьте Get-Location и при необходимости удалите через Проводник только созданную вами папку docx-inventory-… с учебными скриптами и синтетическими файлами. Рабочий оригинал сохраняйте отдельно. Не применяйте рекурсивное удаление по пути, который не проверили.
Результат урока — понятный список частей и связей, завершённый без ошибок, и совпавшие хеши входной копии. Он помогает задать конкретные вопросы о составе файла перед передачей, но не даёт разрешения на загрузку или безопасный запуск.

