Как найти выбранные невидимые символы в тексте для ИИ в Windows
Локальный отчёт по 27 выбранным кодовым точкам в UTF-8-копии: имена Unicode и логические позиции. Это не полный поиск невидимых символов.
- Программы
- Python 3.12.14
Подробности проверки
- Windows 11 (10.0.26300)
- PowerShell 7.6.9 Core
- Python 3.12.14 (AMD64)
- UCD 15.0.0

В текстовой копии для ИИ пробел может оказаться неразрывным, а между буквами — стоять символ нулевой ширины. Вместо удаления всего необычного составим небольшой отчёт: выбранная кодовая точка, её имя и категория Unicode, логическая строка и столбец. Исходный файл останется без правок.
Инструкция рассчитана на читателя, который умеет сохранять .py-файлы и запускать Python в PowerShell. Практическая задача — перед передачей известной текстовой копии ИИ проверить конкретные места и решить, нужно ли объяснить их модели или вручную подготовить другую копию. Отчёт не подтверждает безопасность текста и не определяет, какие символы лишние.
Что понадобится
Нужны Windows, PowerShell и уже имеющийся Python 3.12 со стандартной библиотекой. Ничего устанавливать, подключать к API или отправлять в сеть не требуется. Начните с синтетических примеров ниже. Для собственного текста используйте только небольшую доверенную локальную копию в известной кодировке UTF-8; DOCX, PDF, UTF-16 и произвольный бинарный файл сюда не подходят.
Во всех командах используйте один интерпретатор. В первой строке ниже укажите полный путь к своему уже установленному Python 3.12: приведённый путь — только пример, его нужно заменить. Затем выполните весь блок. Он останавливается при отсутствующем файле, другой версии Python или другой базе Unicode. Продолжайте только после сообщения Version gate passed. Установка Python в этот гайд не входит.
$Python = 'C:\Path\To\Your\Python312\python.exe'
if (-not (Test-Path -LiteralPath $Python -PathType Leaf)) { throw 'Укажите путь к уже установленному Python 3.12' }
& $Python -c "import sys, unicodedata as ud; print(sys.version.split()[0], 'UCD', ud.unidata_version); sys.exit(0 if sys.version_info[:2] == (3, 12) and ud.unidata_version == '15.0.0' else 2)"
if ($LASTEXITCODE -ne 0) { throw 'Нужны Python 3.12 и UCD 15.0.0; остановитесь' }
'Version gate passed'
Документация Python объясняет, что unicodedata возвращает имя и общую категорию кодовой точки; версия базы видна в unidata_version. В авторском прогоне Python 3.12.14 использовал UCD 15.0.0. Полученная официальная документация ветки 3.12 обозначена как 3.12.16: это версия страницы, а не установленного у читателя интерпретатора.
1. Подготовьте учебные файлы
- Создайте новую пустую рабочую папку через Проводник и откройте в ней PowerShell. Не используйте папку с личными документами. Сохраните следующий блок как make_fixtures.py в UTF-8, с расширением .py, а не .py.txt.
- Запустите генератор один раз командой ниже. Он создаёт новую подпапку unicode-lab; если она существует, останавливается до записи. Для повторного опыта выберите другую пустую папку.
from pathlib import Path

root = Path('unicode-lab')
root.mkdir(exist_ok=False)
fixtures = {
    'ordinary.txt': '\u041f\u0440\u0438\u0432\u0435\u0442 \u043c\u0438\u0440\r\n',
    'selected.txt': 'A\u00a0B\u200bC\r\n\ufeffD\u202eE\u202c\n' + 'e\u0301 \U0001f469\u200d\U0001f4bb\ufe0f\tZ\n',
    'bom.txt': '\ufeffABC',
    'newlines.txt': 'A\rB\nC\r\nD\tE\u2028F\u2029G',
    'unselected.txt': 'a\u0308 \U0001f600',
    'empty.txt': '',
    'rows-limit.txt': '\u200b' * 1001,
    'bytes-limit.txt': 'x' * 262145,
}
for name, text in fixtures.items():
    with (root / name).open('xb') as stream:
        stream.write(text.encode('utf-8'))
with (root / 'invalid.txt').open('xb') as stream:
    stream.write(b'A\xffB')
print('Created nine synthetic files in unicode-lab')
& $Python .\make_fixtures.py
$fixtureExit = $LASTEXITCODE
$fixtureExit
Ожидаются сообщение Created nine synthetic files in unicode-lab и код 0. Генератор записывает только учебные файлы. ordinary.txt содержит «Привет мир» и CRLF; selected.txt — выбранные пробелы, форматирующие символы, ударение и последовательность emoji. invalid.txt намеренно содержит недопустимый для UTF-8 байт. Остальные примеры проверяют BOM, окончания строк, пустой ввод, неполноту выбранного набора и два лимита.
2. Сохраните инвентаризатор
Сохраните весь следующий код в unicode_inventory.py рядом с генератором, в UTF-8. Он читает один локальный файл в бинарном режиме, не более 262 145 байтов для проверки границы 262 144 байта (256 КиБ). Затем строго декодирует UTF-8. Неправильные байты вызывают ошибку: замены и угадывания кодировки нет. Входной BOM намеренно сохраняется как U+FEFF: utf-8-sig здесь не используется.
"""Inventory selected code points in one small local UTF-8 copy; never write input."""
import hashlib
from pathlib import Path
import sys
import unicodedata as ud

MAX_BYTES = 262144
MAX_ROWS = 1000
SELECTED = {
    0x0009, 0x000A, 0x000D, 0x00A0, 0x00AD, 0x0301, 0x061C,
    0x200B, 0x200C, 0x200D, 0x200E, 0x200F, 0x2028, 0x2029,
    0x202A, 0x202B, 0x202C, 0x202D, 0x202E, 0x202F, 0x2060,
    0x2066, 0x2067, 0x2068, 0x2069, 0xFE0F, 0xFEFF,
}
ALIASES = {9: 'TAB (editor label)', 10: 'LF (editor label)',
           13: 'CR (editor label)'}

def main():
    if len(sys.argv) != 2:
        raise ValueError('usage: python unicode_inventory.py LOCAL.txt')
    name = sys.argv[1]
    if name.startswith(('\\\\', '//')) or '://' in name:
        raise ValueError('use a local file, not a network path or URL')
    path = Path(name)
    if path.is_symlink() or not path.is_file():
        raise ValueError('expected a regular local file, not a symlink')
    with path.open('rb') as stream:
        raw = stream.read(MAX_BYTES + 1)
    if len(raw) > MAX_BYTES:
        raise ValueError('input exceeds 262144 bytes; no inventory produced')
    text = raw.decode('utf-8', errors='strict')
    rows = []
    line = column = 1
    for index, ch in enumerate(text):
        cp = ord(ch)
        if cp in SELECTED:
            if len(rows) == MAX_ROWS:
                raise ValueError('more than 1000 selected occurrences; no inventory produced')
            rows.append((index + 1, line, column, f'U+{cp:04X}',
                         ud.name(ch, ALIASES.get(cp, '<no Unicode name>')),
                         ud.category(ch)))
        # Only CR, LF and CRLF delimit logical lines. CRLF advances once.
        if ch == '\n' or (ch == '\r' and (index + 1 == len(text) or text[index + 1] != '\n')):
            line += 1
            column = 1
        else:
            column += 1
    print('PYTHON', sys.version.split()[0], 'UCD', ud.unidata_version)
    print('BYTES', len(raw), 'CODEPOINTS', len(text), 'SHA256', hashlib.sha256(raw).hexdigest())
    print('INDEX LINE COLUMN CODEPOINT NAME CATEGORY')
    for row in rows:
        print(*row, sep=' | ')
    print('SELECTED', len(rows), 'POLICY', len(SELECTED), 'code points')
    return 0

if __name__ == '__main__':
    try:
        raise SystemExit(main())
    except (OSError, UnicodeError, ValueError) as error:
        print('ERROR:', ascii(str(error)), file=sys.stderr)
        raise SystemExit(2)
SELECTED — явная редакционная политика из 27 кодовых точек, а не список всех невидимых символов Unicode. В него входят TAB/CR/LF; U+00A0 и U+202F; U+00AD; U+061C; U+200B–U+200F; U+2028–U+202E; U+2060; U+2066–U+2069; U+0301, U+FE0F и U+FEFF. Обычный U+0020 не выводится. U+0301 и U+FE0F добавлены для двух учебных примеров, остальные комбинируемые знаки и variation selectors автоматически не ищутся.
Если выбранных вхождений больше 1000, скрипт возвращает ошибку до печати таблицы. Лимит относится к вхождениям, включая переводы строк, а не к числу разных кодовых точек. Малый файл с множеством строк тоже может его превысить. Это ограниченный учебный инструмент для известных копий; проверка пути и лимит размера не делают его песочницей для недоверенных файлов.
3. Получите отчёт и проверьте входные байты
- Закройте редактор учебного файла. Выполните весь блок ниже: снимите SHA-256, запустите инвентаризатор, немедленно сохраните код завершения, затем снова вычислите SHA-256.
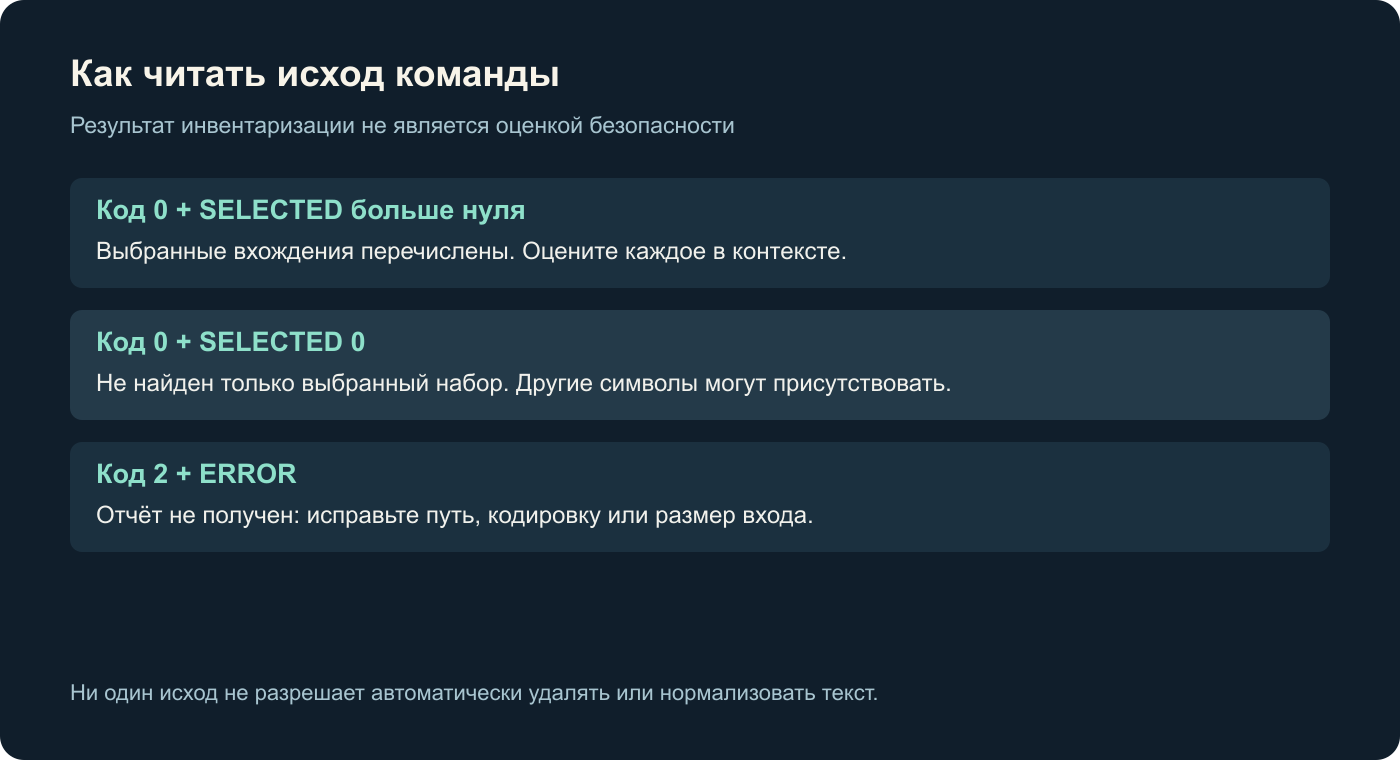
- Проверьте, что код равен 0 и HashUnchanged равно True. Сравните строки отчёта с ожидаемыми позициями ниже; найденное вхождение само по себе не считается ошибкой.
$inputCopy = '.\unicode-lab\selected.txt'
$hashBefore = (Get-FileHash -LiteralPath $inputCopy -Algorithm SHA256).Hash
& $Python .\unicode_inventory.py $inputCopy
$inventoryExit = $LASTEXITCODE
$hashAfter = (Get-FileHash -LiteralPath $inputCopy -Algorithm SHA256).Hash
"Exit=$inventoryExit HashUnchanged=$($hashBefore -eq $hashAfter)"
Для selected.txt ожидаются BYTES 43, CODEPOINTS 23 и SELECTED 13 POLICY 27 code points. Вхождение U+00A0 имеет INDEX 2, LINE 1, COLUMN 2; U+200B — 4, 1, 4; U+FEFF — 8, 2, 1; U+202E — 10, 2, 3; U+0301 — 15, 3, 2; U+200D — 18, 3, 5; U+FE0F — 20, 3, 7. Это ожидаемые значения учебного файла, не результат анализа вашего текста.
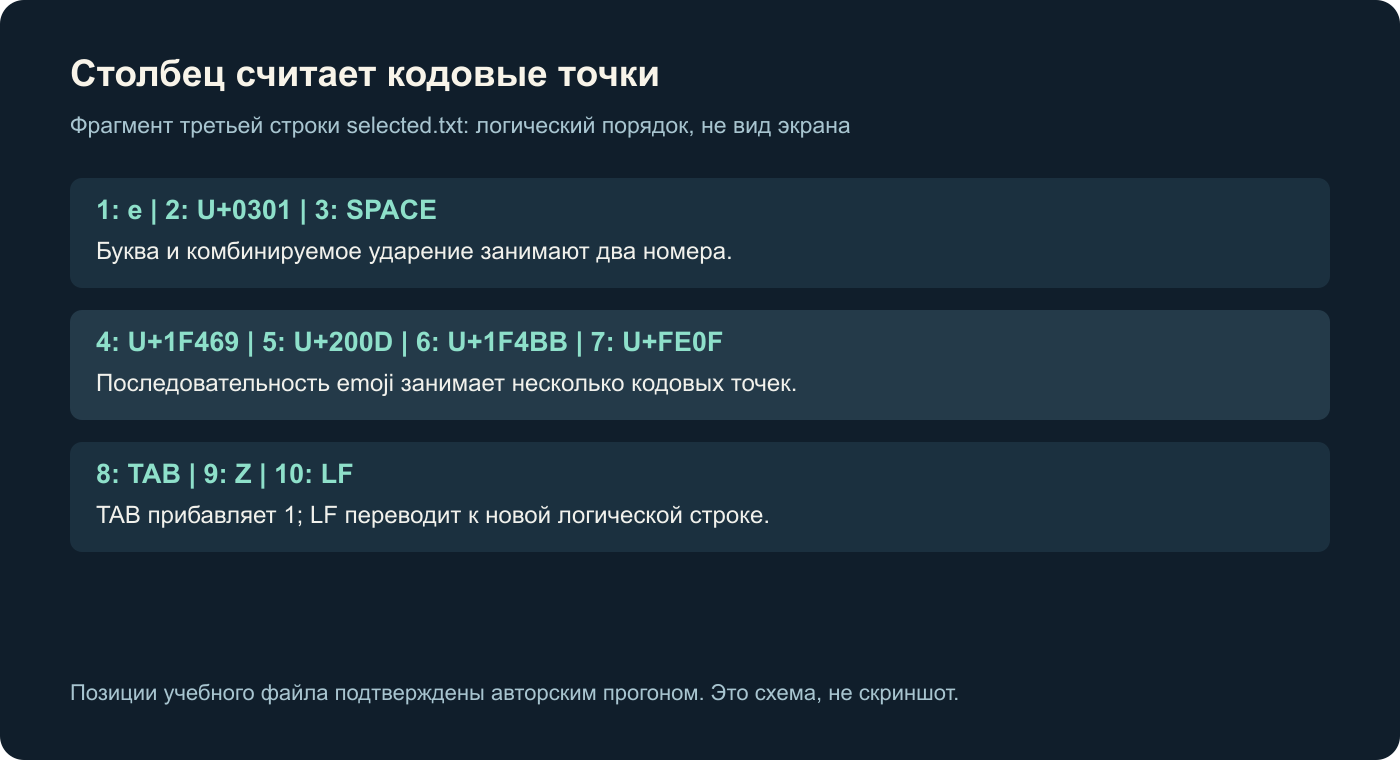
INDEX — порядковый номер кодовой точки от начала текста, LINE и COLUMN — логические координаты, все с 1. Столбец считает кодовые точки Python, а не байты, единицы UTF-16, графемы или клетки экрана. Комбинируемый знак занимает отдельный номер, хотя может отображаться вместе с буквой. Emoji с ZWJ может выглядеть одним знаком, но состоит из нескольких кодовых точек. Поэтому номер столбца в редакторе может отличаться.
Только CR, LF и пара CRLF меняют логическую строку. CRLF печатается двумя вхождениями на прежней строке, затем строка увеличивается один раз. TAB увеличивает столбец на 1, без расширения до табуляционного отступа. U+2028 и U+2029 перечисляются, но по выбранному правилу не меняют LINE. BOM в начале тоже занимает INDEX 1 и COLUMN 1. При bidi-форматировании визуальный порядок может отличаться от логического; отчёт следует порядку в файле и не печатает исходные управляющие символы.
4. Проверьте границы и прочитайте категории
Для каждого имени из таблицы заменяйте значение $inputCopy в предыдущем блоке и запускайте весь блок со снимками SHA заново. Не перенаправляйте вывод в проверяемый файл. Для всех учебных файлов ожидается HashUnchanged=True; код 2 означает, что инвентаризация не получена.
| Файл | Ожидаемый результат |
|---|---|
| ordinary.txt | Код 0; SELECTED 2: только CR и LF, кириллица не перечисляется. |
| bom.txt | Код 0; U+FEFF: INDEX 1, LINE 1, COLUMN 1. |
| newlines.txt | Код 0; SELECTED 7. TAB: строка 4, столбец 2; U+2028: 4/4; U+2029: 4/6. |
| unselected.txt | Код 0; SELECTED 0, хотя в файле есть U+0308 и emoji. |
| empty.txt | Код 0; BYTES 0, CODEPOINTS 0, SELECTED 0. |
| invalid.txt | Код 2; ошибка строгого UTF-8, таблица не печатается. |
| rows-limit.txt | Код 2; 1001 выбранное вхождение превышает предел 1000. |
| bytes-limit.txt | Код 2; 262145 байтов превышают предел 262144. |
Zs — категория пробельного разделителя; Cf — форматирующего символа; Mn — непробельного комбинируемого знака; Cc — управляющего символа. U+2028 и U+2029 имеют Zl и Zp. Для TAB, LF и CR поле NAME содержит помеченные editor label подписи: это редакционные обозначения, поскольку unicodedata.name не даёт им обычного имени. Категория описывает свойство, а не опасность.
Неразрывный пробел может быть нужен между числом и единицей. ZWJ и ZWNJ могут быть значимы для письма и emoji; комбинируемые знаки — для букв и ударений. Bidi-управление тоже требует контекста языка и формата. Не удаляйте строки из отчёта и не просите ИИ автоматически «очистить всё Cf/Mn»: так можно изменить текст.
5. Примените к известной копии для ИИ
- Сохраните оригинал отдельно и подготовьте небольшую локальную .txt-копию с заведомо известной кодировкой UTF-8. Закройте программы, которые могут её сохранять во время команды. Укажите точный локальный путь в $inputCopy и выполните блок с двумя SHA-снимками.
- При коде 0 проверьте каждую нужную позицию в копии и исходном документе. Для ИИ можно явно описать нужные символы: например, «сохрани U+00A0 между числом и единицей». Передавайте только разрешённый к передаче текст; сам отчёт не обезличивает документ.
- При коде 2 сначала разберите причину. Для неверной кодировки запросите корректный экспорт в отдельную копию; не добавляйте errors="replace" или errors="ignore". При превышении лимита выберите небольшой осмысленный фрагмент как новый файл: позиции станут относиться к нему.
Если HashUnchanged=False, прекратите работу с этим результатом: файл между снимками изменился, например из-за редактора. Два SHA-снимка показывают совпадение байтов в эти моменты; это не атомарная блокировка файла и не доказательство его происхождения. Ошибка пути обычно требует Get-Location и проверки точного имени через Get-ChildItem в вашей учебной папке, а не поиска по всем личным каталогам.
Чего отчёт не проверяет и как завершить
Код 0 означает только, что файл прошёл выбранные ограничения и таблица построена. SELECTED 0 не означает отсутствие всех невидимых символов: пример unselected.txt специально это показывает. Скрипт не распознаёт похожие буквы разных алфавитов, не проверяет нормализацию, смысл, инструкции внутри текста, prompt injection или безопасность передачи ИИ. Он не удаляет символы и не вызывает normalize. Поведение конкретного ИИ после вставки или загрузки текста нужно оценивать отдельно.
Инвентаризатор не записывает данные, поэтому откатывать его действие над входом нечего. Если вы затем вручную меняли копию, для возврата используйте отдельно сохранённый оригинал. Учебные файлы можно убрать через Проводник после проверки точной папки unicode-lab; не удаляйте собственные документы. Сохранённые скрипты и отчёты также удаляйте только по их точным именам.

